Caractéristiques techniques de Gemini 3.6 Flash
| Élément | Gemini 3.6 Flash |
|---|---|
| Fournisseur | Google DeepMind |
| ID du modèle | gemini-3.6-flash |
| Famille de modèles | Gemini 3.x |
| Disponibilité | Disponibilité générale (GA) |
| Types d’entrée | Texte, Image, Vidéo, Audio, PDF |
| Types de sortie | Texte |
| Fenêtre de contexte | 1,048,576 jetons |
| Sortie maximale | 65,536 jetons |
| Réflexion | Pris en charge (moyen/élevé) |
| Function calling | Oui |
| Code execution | Oui |
| File Search | Oui |
| URL Context | Oui |
| Search Grounding | Oui |
| Computer Use | Aperçu |
| Structured Output | Oui |
| Caching | Pris en charge |
Source : Documentation de l’API Google Gemini.
Qu’est-ce que Gemini 3.6 Flash ?
Gemini 3.6 Flash est le tout dernier modèle Flash de Google prêt pour la production, conçu pour offrir une intelligence de pointe tout en maintenant la faible latence et l’efficacité coût dont la série Flash est réputée. Il est optimisé pour le codage, la compréhension multimodale, le raisonnement et les workflows pilotés par des agents.
Par rapport à Gemini 3.5 Flash, le modèle améliore la qualité de génération de code, la précision du raisonnement, l’utilisation des outils et l’efficacité en jetons, tout en prenant en charge une fenêtre de contexte massive de 1 million de jetons. Google le positionne comme le modèle de travail par défaut pour les développeurs construisant des agents d’IA et des systèmes d’automatisation complexes.
Principales fonctionnalités de Gemini 3.6 Flash
- Prise en charge du long contexte à 1M de jetons.
- Entrées multimodales natives, incluant texte, images, vidéo, audio et documents PDF.
- Améliorations significatives en génération de code et tâches d’ingénierie logicielle.
- Prise en charge intégrée de Function Calling, File Search, URL Context, Search Grounding et Computer Use.
- Plus économe en jetons que Gemini 3.5 Flash, réduisant le coût d’inférence tout en offrant une qualité supérieure.
- Conçu pour les agents d’IA multi-étapes et les workflows autonomes.
Performances de référence
Google indique que Gemini 3.6 Flash offre de meilleures performances en codage, raisonnement et multimodal que Gemini 3.5 Flash tout en utilisant nettement moins de jetons de sortie. L’entreprise met en avant des performances améliorées sur des benchmarks internes de codage et d’agents et affirme que le modèle peut réduire l’utilisation de jetons de sortie jusqu’à 65 % sur certaines évaluations d’ingénierie logicielle telles que DeepSWE, abaissant ainsi les coûts d’inférence globaux. Google n’a pas publié de tableaux de benchmarks publics complets (p. ex., MMLU, GPQA, SWE-bench Verified) pour cette version.
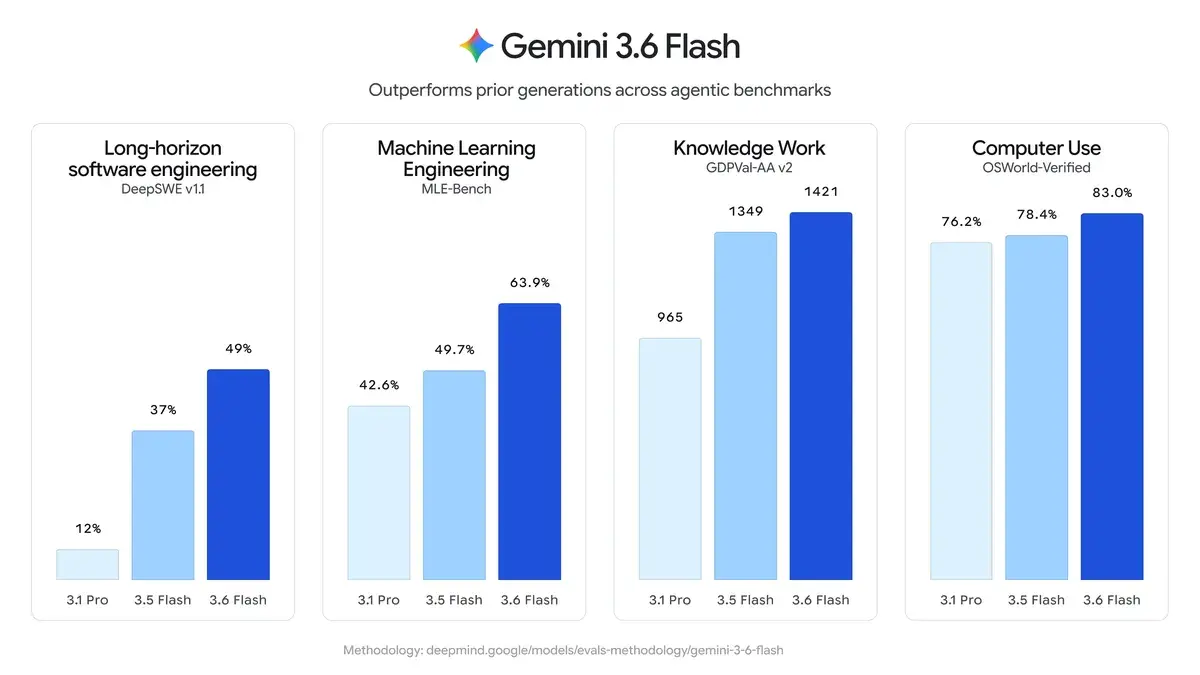
Gemini 3.6 Flash vs Gemini 3.5 Flash vs Gemini 3.1 Pro
| Aspect | Gemini 3.6 Flash | Gemini 3.5 Flash | Gemini 3.1 Pro |
|---|---|---|---|
| Date de sortie | 21 juillet 2026 (GA) | Début 2026 | ~févr. 2026 (Aperçu) |
| Positionnement | Cheval de bataille efficace pour agents, codage, multimodal | Ancien modèle Flash orienté agents | Raisonnement avancé de niveau Pro |
| Tarification (par 1M de jetons) | Input: $1.50Output: $7.50 | Input: $1.50Output: $9.00 | Plus élevé (p. ex., ~$2 entrée / $12 sortie) |
| Efficacité en jetons | 17 % de jetons de sortie en moins vs 3.5 Flash ; moins d’étapes/appels d’outils | Référence | Moins efficace dans les workflows agentiques |
| Vitesse | Élevée (famille Flash) | Élevée | Plus lente que les modèles Flash |
| Fenêtre de contexte | 1M de jetons | 1M de jetons | Probablement similaire |
| Atouts | Codage, travail de connaissance, multimodal (graphiques/documents), Computer Use, efficacité agentique | Bon équilibre agentique/codage | Raisonnement plus poussé sur des problèmes complexes |
Résumé rapide
- 3.6 Flash → Meilleur choix global pour la plupart des utilisateurs aujourd’hui : plus rapide, moins coûteux par tâche, plus efficace que 3.5 Flash et surpasse 3.1 Pro sur de nombreux benchmarks pratiques/agentiques.
- 3.5 Flash → Solide prédécesseur ; toujours capable mais supplanté par 3.6 Flash (coût de jetons de sortie plus élevé, moins efficace).
- 3.1 Pro → Plus fort dans certains scénarios de raisonnement profond mais plus lent, plus coûteux, et généralement à la traîne des nouveaux modèles Flash en vitesse, efficacité et nombreuses tâches réelles/agentiques.
Limites
- La génération d’images n’est pas directement prise en charge.
- La génération audio n’est pas disponible.
- Computer Use reste en Aperçu.
- Certains paramètres de génération hérités (
temperature,top_p,top_k) ont été supprimés de la nouvelle interface API. - Les meilleures performances sont obtenues via la dernière Gemini Interactions API.
Comment accéder à l’API Gemini 3.6 Flash
Étape 1 : Obtenir l’accès à l’API
Connectez-vous à cometAPI. Si vous n’êtes pas encore utilisateur, veuillez vous inscrire d’abord. Connectez-vous à votre CometAPI console. Obtenez la clé API d’authentification de l’interface. Cliquez sur “Add Token” dans la section API token du centre personnel, obtenez la clé de jeton : sk-xxxxx et soumettez.
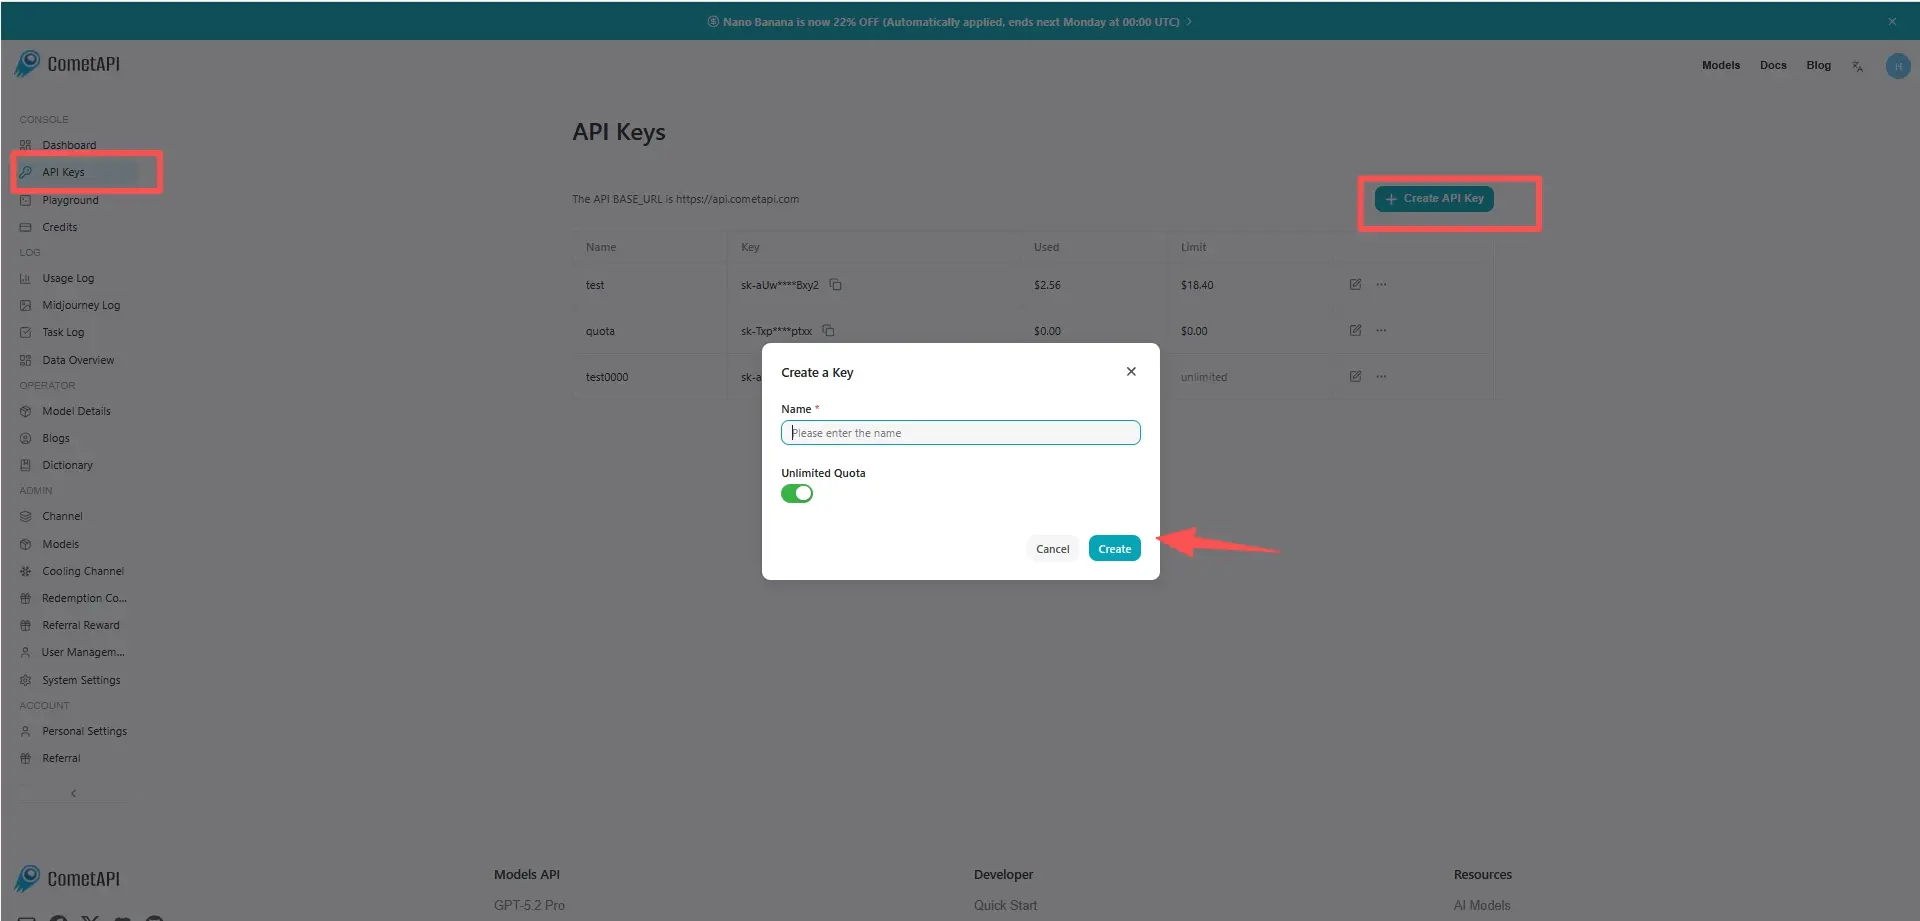
Étape 2 : Envoyer des requêtes à l’API Gemini 3.6 Flash
Sélectionnez l’endpoint “ gemini-3.6-flash" "gemini-3.6-flash-thinking” pour envoyer la requête API et définir le corps de la requête. La méthode et le corps de la requête sont disponibles dans la documentation API de notre site Web. Notre site propose également un test Apifox pour votre commodité. Remplacez <YOUR_API_KEY> par votre clé CometAPI réelle depuis votre compte. l’URL de base est Gemini Generating Content
Insérez votre question ou votre demande dans le champ content—c’est à cela que le modèle répondra. Traitez la réponse de l’API pour obtenir la réponse générée.
Étape 3 : Traiter les réponses
L’API renvoie des réponses candidates structurées, incluant le texte généré, des citations, des métadonnées de sécurité et, en option, des sorties d’outils.