Spécifications techniques de GLM-5.2
| Élément | GLM-5.2 |
|---|---|
| Fournisseur | Zhipu AI |
| Date de sortie | 13 juin 2026 |
| Type de modèle | LLM Mixture-of-Experts (MoE) à poids ouverts |
| Paramètres totaux | ~744B |
| Paramètres actifs | ~40B par token |
| Fenêtre de contexte | 1,000,000 tokens |
| Sortie maximale | 131,072 tokens |
| Modes de raisonnement | High, Max |
| Licence | MIT |
| Focus principal | Codage agentique, génie logiciel, raisonnement à long horizon |
| Disponibilité de l’API | Plateforme Z.ai et fournisseurs compatibles |
| Poids ouverts | Oui |
GLM-5.2 est le dernier modèle phare de la famille GLM de Zhipu AI. Contrairement aux modèles généralistes de pointe, GLM-5.2 est principalement positionné comme un modèle axé sur le code et orienté agent, conçu pour l’ingénierie logicielle à l’échelle des référentiels, les workflows autonomes et le raisonnement sur des contextes extrêmement longs. Sa capacité phare est une fenêtre de contexte native de 1 million de tokens, ce qui en fait l’une des plus grandes fenêtres de contexte publiquement disponibles parmi les modèles à poids ouverts.
Principales fonctionnalités de GLM-5.2
- Fenêtre de contexte de 1M tokens pour des référentiels entiers, des ensembles de documentation volumineux et des workflows multi‑sessions d’agents.
- Optimisation prioritaire pour le codage, axée sur le refactoring, le débogage, la génération de code et les tâches d’ingénierie logicielle.
- Prise en charge des workflows orientés agents pour des outils tels que Claude Code, Cline, Roo Code, OpenCode et des agents de codage similaires.
- Publication à poids ouverts sous licence MIT, permettant l’auto‑hébergement et l’affinage.
- Deux modes de raisonnement (High et Max) offrant un compromis entre latence et profondeur de raisonnement.
- Grande architecture MoE avec environ 744B de paramètres totaux tout en n’activant qu’environ ~40B par token pour l’efficacité.
Performances de référence de GLM-5.2
Zhipu n’a pas publié de résultats de benchmarks officiels complets lors du lancement, ce qui rend les comparaisons directes plus incertaines que pour des modèles tels que GPT-5 ou Claude. Plusieurs rapports du secteur signalent l’absence de publications de benchmarks validées de manière indépendante.
| Benchmark | Score rapporté |
|---|---|
| Terminal-Bench 2.1 | 81.0 |
| SWE-Bench Pro | 62.1 |
| NL2Repo | 48.9 |
| AIME 2026 | 99.2 |
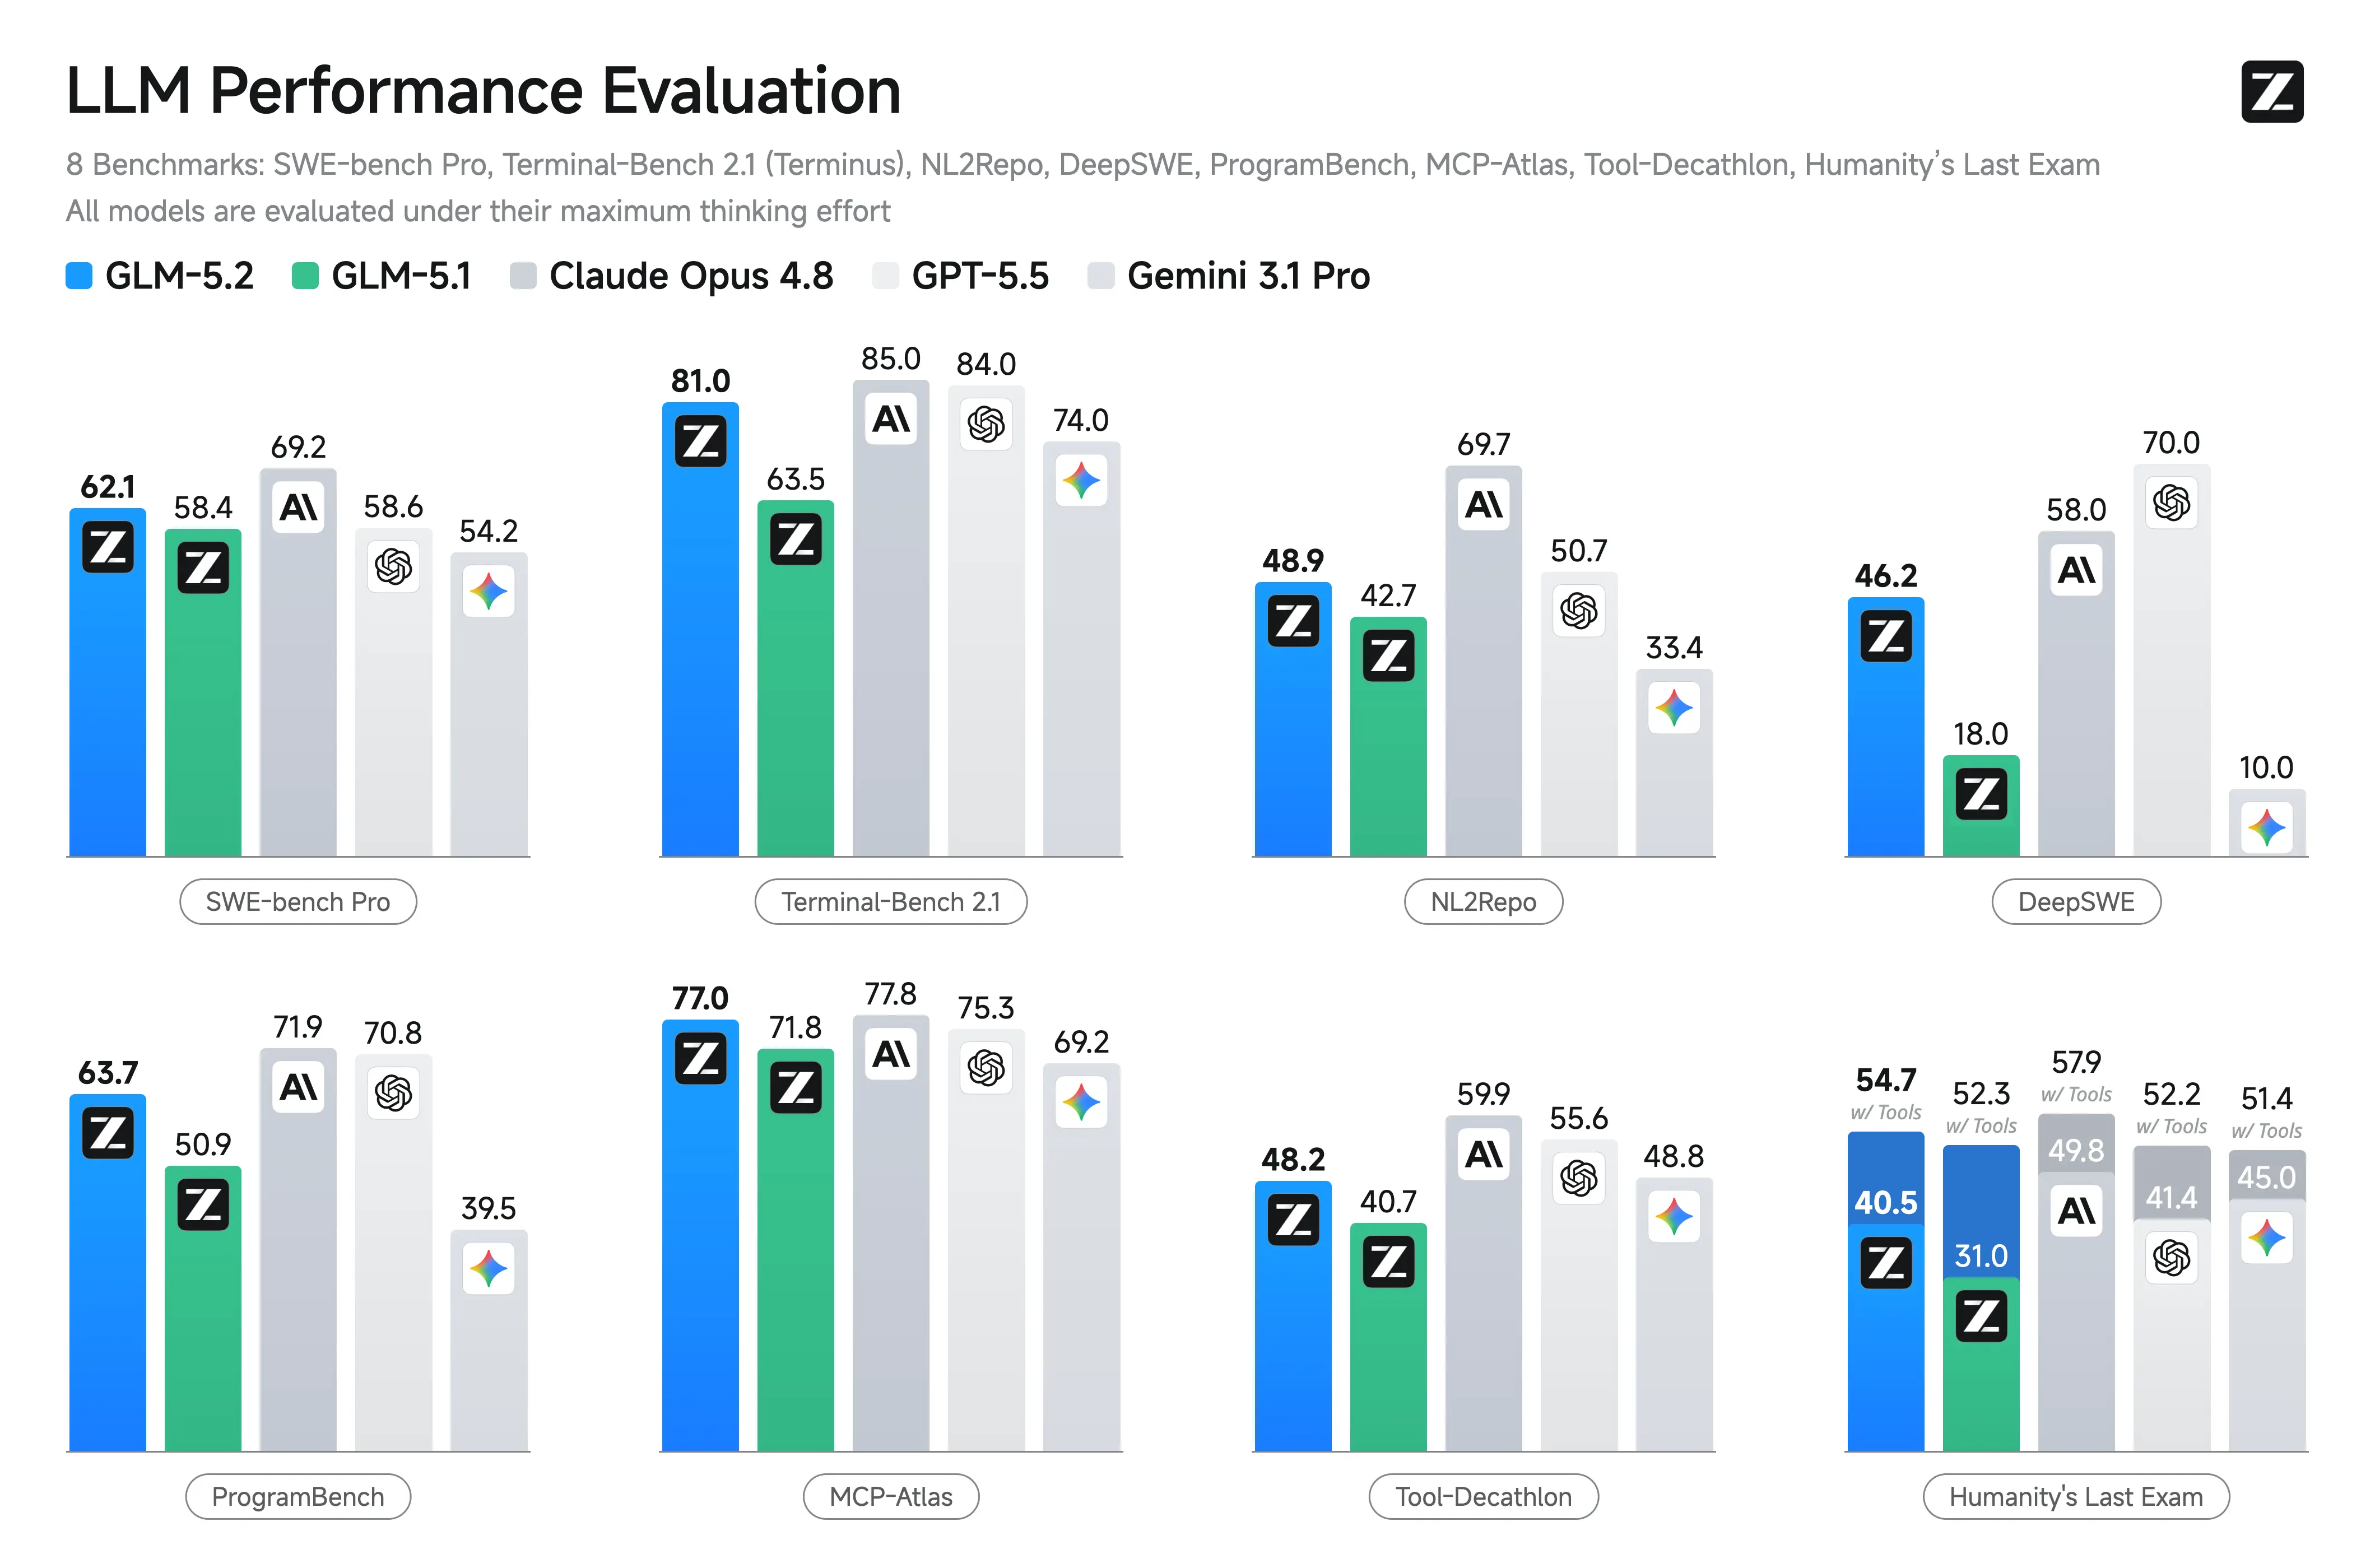
GLM-5.2 vs GLM-5.1 vs Claude Opus 4.8
| Spécification | GLM-5.2 | GLM-5.1 | Claude Opus 4.8 |
|---|---|---|---|
| Date de sortie | 2026-06-13 | 2026 | 2026 |
| Fenêtre de contexte | 1,000,000 | ~200,000 | 1,000,000 |
| Poids ouverts | Oui (MIT) | Oui | Non |
| Modes de raisonnement | High, Max | Standard | Extended Thinking |
| Paramètres totaux | 744B | 744B | Non divulgué |
| Paramètres actifs | 40B | 40B | Non divulgué |
| Données officielles de benchmark | Non publiées | Publiées au lancement | Publiées |
La principale amélioration documentée de GLM-5.2 par rapport à GLM-5.1 est son extension à une fenêtre de contexte de 1M tokens et l’introduction de modes de raisonnement sélectionnables High et Max. Au lancement, Z.ai n’a pas publié de résultats officiels pour SWE-Bench, LiveCodeBench, HumanEval ou des benchmarks similaires, de sorte que les comparaisons de performance avec Claude Opus 4.8, GPT-5, DeepSeek ou les modèles Qwen restent non vérifiées.
Comparé à d’autres modèles ouverts, le principal différenciateur de GLM-5.2 est la combinaison d’une très grande fenêtre de contexte, d’une spécialisation pour le codage et d’une licence MIT. Son attrait le plus fort concerne l’ingénierie logicielle à l’échelle des référentiels plutôt que les applications de chat généralistes.
Pourquoi utiliser GLM-5.2 via CometAPI ?
CometAPI permet aux développeurs d’intégrer GLM-5.2 en utilisant la même interface que celle employée pour des dizaines de modèles d’IA leaders.
Les avantages incluent :
- Authentification unifiée auprès de plusieurs fournisseurs
- Intégration API compatible OpenAI
- Facturation et gestion d’usage simplifiées
- Expérimentation rapide avec des modèles alternatifs
- Passage aisé entre des modèles de code, de raisonnement, d’image, d’audio et de vidéo
- Réduction du verrouillage fournisseur pour les systèmes de production
Que vous construisiez un IDE IA, un assistant interne pour l’ingénierie ou une plateforme d’automatisation d’entreprise, CometAPI minimise l’effort d’intégration tout en préservant la flexibilité.
Comment accéder à l’API GLM-5.2 sur CometAPI
Commencez avec notre produit en quelques étapes simples...
Étape 1 : Inscrivez-vous pour obtenir votre clé API GLM-5.2
Créez un compte sur CometAPI et accédez au tableau de bord API pour générer votre clé API GLM-5.2. Cette clé authentifie toutes vos requêtes et vous donne un accès immédiat à l’ensemble des capacités de l’API GLM-5.2, y compris la fenêtre de contexte de 1M tokens et 128k jetons de sortie.
Étape 2 : Envoyez des requêtes à l’API GLM-5.2
Utilisez votre clé API GLM-5.2 pour envoyer des requêtes POST vers l’endpoint CometAPI. Transmettez votre prompt, définissez des paramètres de modèle comme le niveau d’effort et le nombre maximal de tokens, et l’API GLM-5.2 traite votre requête — gérant tout, de la génération de code à l’analyse de documents, jusqu’à l’utilisation agentique d’outils.
Étape 3 : Récupérez les résultats et intégrez l’API GLM-5.2
L’API GLM-5.2 fournit des réponses structurées, incluant le texte de complétion, des instructions d’appel d’outils et des métadonnées d’usage de tokens. Elle prend en charge à la fois les réponses synchrones standard et le streaming en temps réel via Server-Sent Events (SSE) lorsque stream: true est configuré. L’endpoint peut être facilement intégré dans vos workflows existants à l’aide de clients HTTP standard ou de SDK compatibles OpenAI, en faisant transiter les requêtes via url(//api.cometapi.com/v1) avec votre Bearer Token.