

在快速發展的人工智慧領域,DeepSeek 已經成為一個強大的競爭者,向 OpenAI 和谷歌等老牌巨頭發起挑戰。 DeepSeek 是一家中國人工智慧公司,由梁文峰於 2023 年 2 月創立,因其對大型語言模型 (LLM) 的創新方法和對開源開發的承諾而備受關注。本文深入探討了 DeepSeek 模型的架構、創新和意義,特別關注其混合專家 (MoE) 框架以及 DeepSeek-V1 和 DeepSeek-RXNUMX 模型的進步。
什麼是 DeepSeek 以及它為何重要?
人工智慧 (AI) 正在迅速發展,其中 DeepSeek 是迄今為止最雄心勃勃的項目之一。 DeepSeek 由前頂級人工智慧工程師和研究人員團隊開發,代表了新一代開源語言模型,旨在彌合大型專有模型(如 GPT-4)與開放研究社群之間的差距。
DeepSeek 於 2024 年底推出,引入了有關訓練效率、擴展和記憶檢索的幾個新穎的想法,突破了開放模型所能實現的極限。
DeepSeek 的架構與傳統模型有何不同?
什麼是 MoE?
在傳統的密集神經網路中,每個輸入都會經過整個網絡,無論輸入的性質如何,都會激活所有參數。這種方法雖然簡單,但會導致效率低下,尤其是在模型擴大時。
混合專家架構透過將網路劃分為多個子網路或「專家」來解決這個問題,每個子網路或「專家」專門負責不同的任務或資料模式。門控機制會為每個輸入動態地選擇這些專家的子集,確保只啟動網路中最相關的部分。這種選擇性活化減少了計算開銷並允許更大的模型專業化。
混合專家架構是一種旨在提高大型神經網路效率和可擴展性的技術。 MoE 不會為每個輸入啟動所有參數,而是根據輸入資料選擇性地啟用一組專門的「專家」網路。這種方法減少了計算負荷並允許更有針對性的處理。
DeepSeek 的 MoE 實現
DeepSeek 的模型(例如 DeepSeek-R1 和 DeepSeek-V2)採用了先進的 MoE 框架。例如,DeepSeek-R1 包含 671 億個參數,但在任何給定的前向傳遞過程中只有 37 億個參數被啟動。這種選擇性活化由複雜的門控機制管理,該機制將輸入路由給最相關的專家,從而優化計算效率而不影響效能。
簡化後的 DeepSeek Transformer 是什麼樣的呢?
以下是 DeepSeek 如何實作稀疏混合專家機制的簡化程式碼範例:
pythonimport torch
import torch.nn as nn
import torch.nn.functional as F

class Expert(nn.Module):
    def __init__(self, hidden_dim):
        super(Expert, self).__init__()
        self.fc = nn.Linear(hidden_dim, hidden_dim)

    def forward(self, x):
        return F.relu(self.fc(x))

class SparseMoE(nn.Module):
    def __init__(self, hidden_dim, num_experts=8, k=2):
        super(SparseMoE, self).__init__()
        self.experts = nn.ModuleList()
        self.gate = nn.Linear(hidden_dim, num_experts)
        self.k = k

    def forward(self, x):
        scores = self.gate(x)
        topk = torch.topk(scores, self.k, dim=-1)
        output = 0
        for idx in range(self.k):
            expert_idx = topk.indices
            expert_weight = F.softmax(topk.values, dim=-1)
            expert_output = torch.stack((x) for j, i in enumerate(expert_idx)])
            output += expert_weight.unsqueeze(-1) * expert_output
        return output

# Example usage

batch_size, hidden_dim = 16, 512
x = torch.randn(batch_size, hidden_dim)
model = SparseMoE(hidden_dim)
out = model(x)
print(out.shape)  # Output shape: (16, 512)
這個基本範例模擬根據輸入動態選擇 2 位專家並彙總他們的輸出。

DeepSeek 使用了哪些訓練策略?
如何處理資料收集和管理?
DeepSeek 的創作者非常重視 數據質量 數量上。 OpenAI 和其他公司從整個公共互聯網收集數據,而 DeepSeek 則結合了以下數據:
- 精選開放資料集(Pile、Common Crawl 片段)
- 學術語料庫
- 程式碼儲存庫(如 GitHub)
- 使用較小的監督模型產生的特殊合成資料集
他們的訓練包括 多級 課程學習方法:
- 早期階段採用更簡單、更真實的資料集進行訓練
- 後期階段強調推理與編碼任務
採用了哪些優化技術?
有效地訓練大型語言模型仍然是一項重大挑戰。 DeepSeek 的採用:
- ZeRO-3 平行性:在 GPU 之間分割最佳化器狀態、梯度和參數。
- 訓練期間的 Int8 量化:在不損害模型品質的情況下盡量減少記憶體使用。
- 自適應學習率:使用諸如餘弦退火和預熱之類的技術。
以下是展示自適應學習率調度的簡單程式碼片段:
pythonfrom torch.optim.lr_scheduler import CosineAnnealingLR

optimizer = torch.optim.AdamW(model.parameters(), lr=1e-4)
scheduler = CosineAnnealingLR(optimizer, T_max=100)

for epoch in range(100):
    train(model)
    validate(model)
    scheduler.step()
此程式碼在訓練期間平滑地調整學習率。
DeepSeek 如何實現卓越性能?
檢索起什麼作用?
DeepSeek 整合了一個內建檢索系統——類似於將搜尋引擎插入神經網路。當給予提示時,模型可以:
- 對查詢進行編碼
- 從外部記憶體檢索相關文檔
- 將文件與自己的內部知識融合
這使得 DeepSeek 比傳統的封閉模型更能保持事實性和最新性。
從概念上講,它看起來像這樣:
pythonclass Retriever:
    def __init__(self, index):
        self.index = index  # Assume some pre-built search index

    def retrieve(self, query_embedding):
        # Search based on similarity

        return self.index.search(query_embedding)

class DeepSeekWithRetriever(nn.Module):
    def __init__(self, model, retriever):
        super().__init__()
        self.model = model
        self.retriever = retriever

    def forward(self, query):
        embedding = self.model.encode(query)
        docs = self.retriever.retrieve(embedding)
        augmented_input = query + " " + " ".join(docs)
        output = self.model.generate(augmented_input)
        return output
這種 檢索增強生成 (RAG) 大大增強了DeepSeek的長期推理能力。
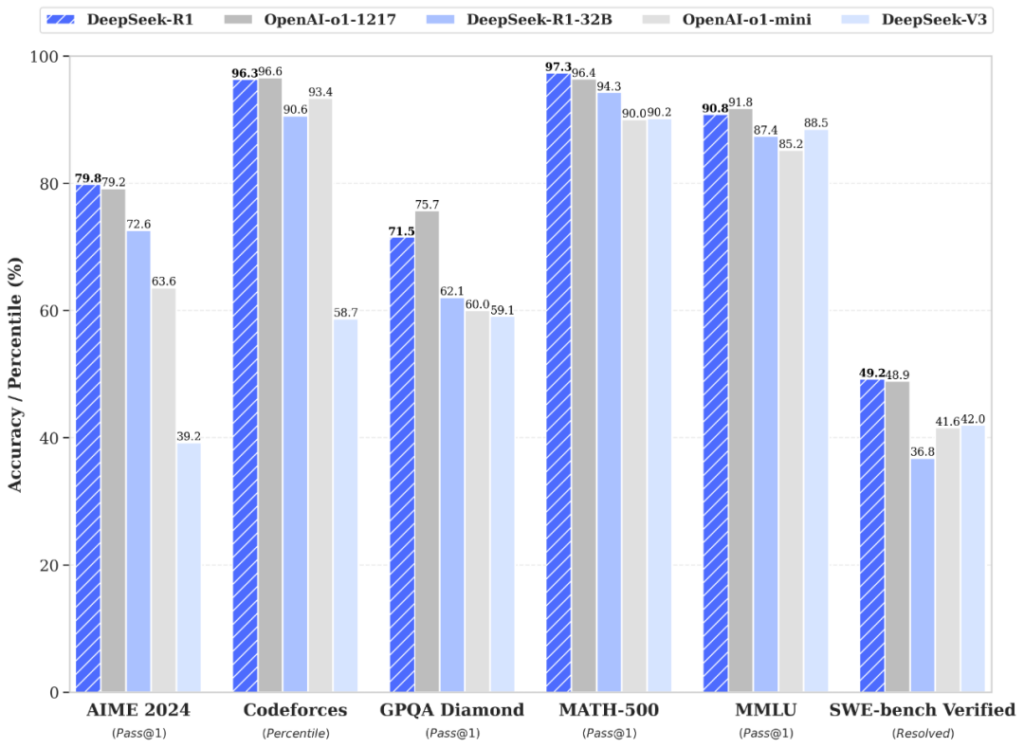
DeepSeek 的評價如何?
此模型的基準測試使用:
- 百萬美元:多任務語言理解
- 人類評估:程式碼產生準確率
- 真實的質量保證: 能夠如實回答
- BIG-長凳:一般廣泛的人工智慧評估
在大多數情況下,DeepSeek 最大的模型(30B、65B 個參數)在推理任務上與 GPT-4-turbo 相當甚至超過 GPT-XNUMX-turbo,同時運行成本仍然顯著降低。
DeepSeek 還面臨哪些挑戰?
儘管令人印象深刻,但 DeepSeek 並非沒有缺陷:
- 偏見和毒性:即使是精心策劃的資料集也可能洩漏有問題的輸出。
- 檢索延遲:RAG 系統可能比純生成模型慢。
- 計算成本:即使採用 MoE,訓練和使用這些模型仍然很昂貴。
DeepSeek 團隊正在積極致力於修剪模型、更聰明的檢索演算法和偏見緩解。
結論
DeepSeek 代表了自基於 Transformer 的模型興起以來開放式 AI 發展中最重要的轉變之一。透過稀疏專家、檢索整合和更聰明的訓練目標等架構創新,它為開放模型所能實現的目標設定了新的標準。
隨著人工智慧領域的發展,DeepSeek(及其衍生產品)有望在塑造下一波智慧應用方面發揮重要作用。
入門
開發人員可以訪問 DeepSeek R1 API DeepSeek V3 API 通過 彗星API。首先,在 Playground 中探索模型的功能,並查閱 API指南 以獲得詳細說明。請注意,一些開發人員可能需要在使用該模型之前驗證他們的組織。