Technische Spezifikationen von Gemini 3.6 Flash
| Parameter | Gemini 3.6 Flash |
|---|---|
| Anbieter | Google DeepMind |
| Modell-ID | gemini-3.6-flash |
| Modellfamilie | Gemini 3.x |
| Verfügbarkeit | Allgemeine Verfügbarkeit (GA) |
| Eingabetypen | Text, Bild, Video, Audio, PDF |
| Ausgabetypen | Text |
| Kontextfenster | 1,048,576 Token |
| Maximale Ausgabe | 65,536 Token |
| Denken | Unterstützt (mittel/hoch) |
| Funktionsaufrufe | Ja |
| Codeausführung | Ja |
| Dateisuche | Ja |
| URL-Kontext | Ja |
| Search Grounding | Ja |
| Computerbedienung | Vorschau |
| Strukturierte Ausgabe | Ja |
| Zwischenspeicherung | Unterstützt |
Quelle: Google Gemini API-Dokumentation.
Was ist Gemini 3.6 Flash?
Gemini 3.6 Flash ist Googles neuestes produktionsreifes Flash-Modell, das darauf ausgelegt ist, Intelligenz auf Spitzen-Niveau zu liefern und gleichzeitig die niedrige Latenz und Kosteneffizienz beizubehalten, für die die Flash-Serie bekannt ist. Es ist für Programmierung, multimodales Verständnis, Schlussfolgern und agentische Workflows optimiert.
Im Vergleich zu Gemini 3.5 Flash verbessert das Modell die Qualität der Codegenerierung, die Genauigkeit beim Schlussfolgern, die Tool-Nutzung und die Token-Effizienz, während es ein enormes Kontextfenster von 1 Million Token unterstützt. Google positioniert es als das Standard-Arbeitspferd für Entwickler, die KI-Agenten und komplexe Automatisierungssysteme bauen.
Hauptfunktionen von Gemini 3.6 Flash
- Unterstützt die Verarbeitung von langen Kontexten mit 1M-Token.
- Native multimodale Eingaben, einschließlich Text, Bilder, Video, Audio und PDF-Dokumente.
- Deutliche Verbesserungen bei der Codegenerierung und bei Aufgaben der Softwaretechnik.
- Eingebaute Unterstützung für Funktionsaufrufe (Function Calling), Dateisuche (File Search), URL-Kontext (URL Context), Search Grounding und Computerbedienung (Computer Use).
- Token-effizienter als Gemini 3.5 Flash, senkt die Inferenzkosten bei gleichzeitig höherer Qualität.
- Ausgelegt für mehrschrittige KI-Agenten und autonome Workflows.
Benchmark-Leistung
Google berichtet, dass Gemini 3.6 Flash stärkere Leistungen in den Bereichen Programmierung, Schlussfolgern und Multimodalität als Gemini 3.5 Flash erbringt und dabei deutlich weniger Ausgabetoken nutzt. Das Unternehmen hebt verbesserte Ergebnisse in internen Benchmarks für Programmierung und agentische Aufgaben hervor und erklärt, dass das Modell den Ausgabetoken-Verbrauch in bestimmten Software-Engineering-Bewertungen wie DeepSWE um bis zu 65 % senken kann, was die Gesamtkosten der Inferenz reduziert. Für diese Veröffentlichung hat Google keine umfassenden öffentlichen Benchmark-Tabellen (z. B. MMLU, GPQA, SWE-bench Verified) publiziert.
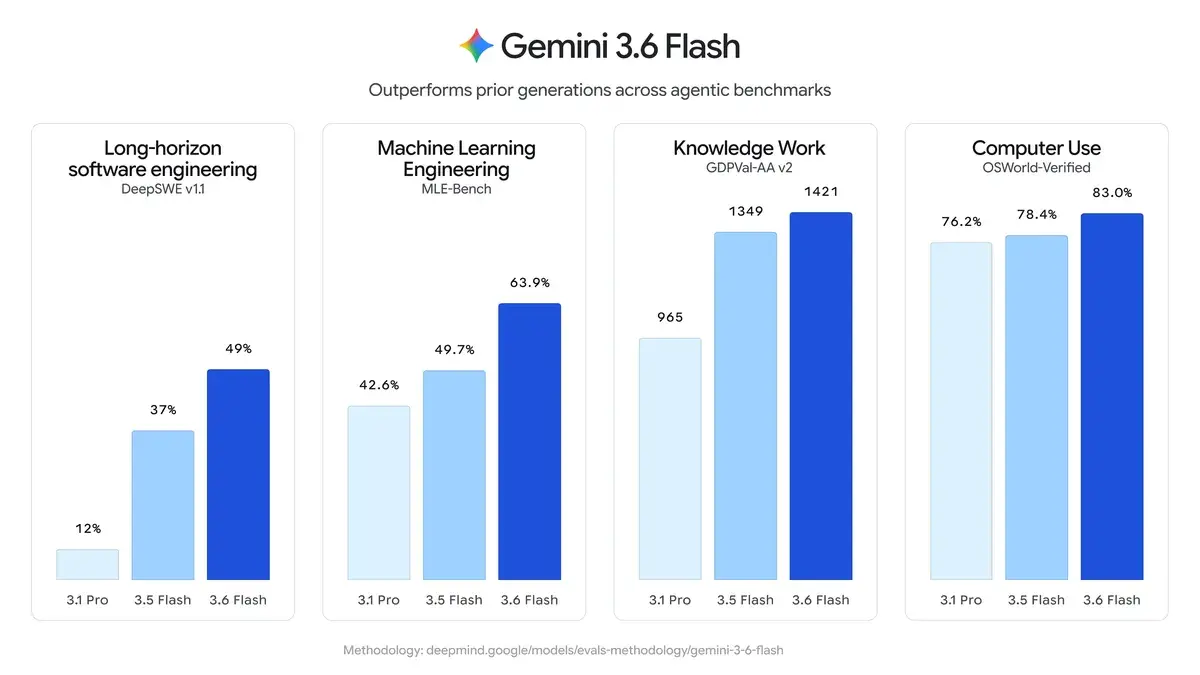
Gemini 3.6 Flash vs Gemini 3.5 Flash vs Gemini 3.1 Pro
| Aspekt | Gemini 3.6 Flash | Gemini 3.5 Flash | Gemini 3.1 Pro |
|---|---|---|---|
| Veröffentlichung | 21. Juli 2026 (GA) | früher in 2026 | ~Februar 2026 (Vorschau) |
| Positionierung | Effizientes Arbeitspferd für Agenten, Programmierung, Multimodalität | Frühere agentische Flash-Version | Fortgeschrittenes Pro-Tier-Schlussfolgern |
| Preisgestaltung (pro 1M Token) | Eingabe: $1.50Ausgabe: $7.50 | Eingabe: $1.50Ausgabe: $9.00 | Höher (z. B. ~$2 Eingabe / $12 Ausgabe) |
| Token-Effizienz | 17 % weniger Ausgabetoken als 3.5 Flash; weniger Schritte/Tool-Aufrufe | Basiswert | Weniger effizient in agentischen Workflows |
| Geschwindigkeit | Hoch (Flash-Familie) | Hoch | Langsamer als Flash-Modelle |
| Kontextfenster | 1M Token | 1M Token | Vermutlich ähnlich |
| Stärken | Programmierung, Wissensarbeit, Multimodalität (Diagramme/Dokumente), Computerbedienung, agentische Effizienz | Gute Balance zwischen Agentik/Programmierung | Tieferes Schlussfolgern bei komplexen Problemen |
Kurzzusammenfassung
- 3.6 Flash → Beste Gesamtauswahl für die meisten Nutzer derzeit: schneller, pro Aufgabe günstiger, effizienter als 3.5 Flash und übertrifft 3.1 Pro bei vielen praktischen/agentischen Benchmarks.
- 3.5 Flash → Solider Vorgänger; weiterhin leistungsfähig, wird aber von 3.6 Flash abgelöst (höhere Kosten für Ausgabetoken, weniger effizient).
- 3.1 Pro → Stärker in einigen Szenarien des tiefen Schlussfolgerns, aber langsamer, teurer und bleibt gegenüber den neueren Flash-Modellen in Geschwindigkeit, Effizienz und vielen realen/agentischen Aufgaben zurück.
Einschränkungen
- Bildgenerierung wird nicht direkt unterstützt.
- Audiogenerierung ist nicht verfügbar.
- Computerbedienung bleibt in der Vorschau.
- Einige ältere Generierungsparameter (
temperature,top_p,top_k) wurden aus der neuen API-Schnittstelle entfernt. - Die beste Leistung wird über die neueste Gemini Interactions API erreicht.
So greifen Sie auf die Gemini 3.6 Flash API zu
Schritt 1: API-Zugriff erhalten
Melden Sie sich bei cometAPI an. Wenn Sie noch kein Nutzer sind, registrieren Sie sich bitte zuerst. Melden Sie sich bei Ihrer CometAPI-Konsole an. Holen Sie sich den Zugriffsberechtigungs-API-Schlüssel der Schnittstelle. Klicken Sie im persönlichen Bereich beim API-Token auf „Add Token“, erhalten Sie den Token-Schlüssel: sk-xxxxx und senden Sie ihn ab.
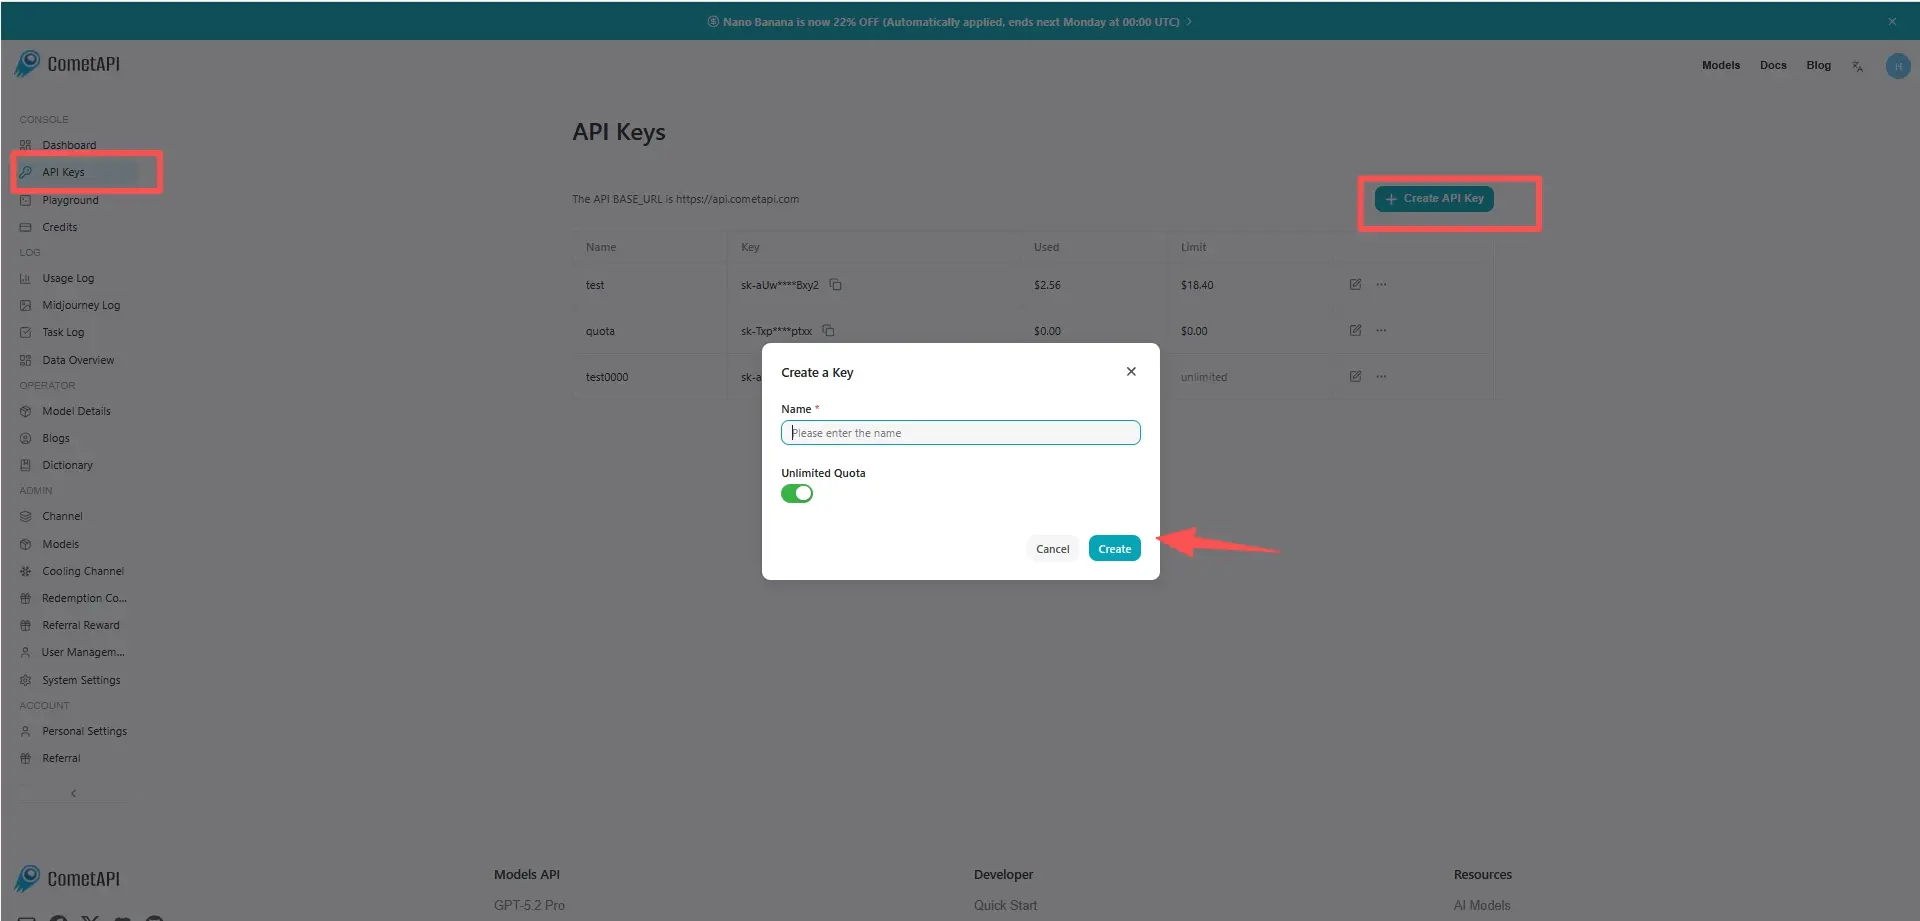
Schritt 2: Anfragen an die Gemini 3.6 Flash API senden
Wählen Sie den „ gemini-3.6-flash" "gemini-3.6-flash-thinking” Endpoint, um die API-Anfrage zu senden, und legen Sie den Request-Body fest. Die Anfragemethode und der Request-Body werden aus der API-Dokumentation unserer Website entnommen. Unsere Website bietet Ihnen zudem Apifox-Tests zur einfachen Nutzung. Ersetzen Sie <YOUR_API_KEY> durch Ihren tatsächlichen CometAPI-Schlüssel aus Ihrem Konto. Basis-URL ist Gemini Content-Erzeugung
Fügen Sie Ihre Frage oder Anfrage in das content-Feld ein — darauf wird das Modell antworten . Verarbeiten Sie die API-Antwort, um die generierte Antwort zu erhalten.
Schritt 3: Antworten verarbeiten
Die API gibt strukturierte Kandidatenantworten zurück, einschließlich generiertem Text, Zitaten, Sicherheitsmetadaten und optionalen Tool-Ausgaben.