

Mistral 3 es la versión principal de la familia de modelos de finales de 2025 de Mistral AI. Aporta una combinación de modelos compactos y rápidos orientados al despliegue local/en el edge y un buque insignia muy grande y disperso que impulsa el estado del arte en escala y longitud de contexto. Este artículo explica qué es Mistral 3, cómo está construido, por qué puede interesarte ejecutarlo localmente y tres formas prácticas de ejecutarlo en tu máquina o servidor privado — desde la comodidad de “clic para ejecutar” de Ollama hasta el servicio en GPU de producción con vLLM/TGI, pasando por la inferencia en CPU para dispositivos diminutos usando GGUF + llama.cpp.
¿Qué es Mistral 3?
Mistral 3 es la última generación de modelos de pesos abiertos de Mistral AI. La familia incluye tanto un Mistral Large 3 masivo (un modelo disperso Mixture-of-Experts — MoE) como varias variantes para edge/“ministral” (3B, 8B, 14B) ajustadas para seguir instrucciones y tareas multimodales (texto+visión). Mistral posicionó el lanzamiento para que fuera ampliamente utilizable: desde inferencia de alto rendimiento en centros de datos (con puntos de control optimizados especializados) hasta uso en el edge y portátiles mediante formatos cuantizados y variantes más pequeñas.
Propiedades prácticas clave:
- Una arquitectura de Mixture-of-Experts (MoE) en la variante Large 3 que produce un recuento de parámetros “total” muy grande mientras solo activa un subconjunto de expertos por token — esto mejora la eficiencia a escala.
- Una familia de modelos Ministral 3 (3B / 8B / 14B) pensados para uso en el edge y local, con variantes ajustadas a instrucciones y multimodales.
- Puntos de control oficiales y un conjunto de puntos de control optimizados (NVFP4/FP8) para tiempos de ejecución acelerados como vLLM y plataformas de NVIDIA.
- Multimodal + multilingüe + contexto largo — las variantes Ministral y Large enfatizan la comprensión imagen+texto y una amplia cobertura de idiomas. Para aplicaciones que mezclan imágenes + documentos largos, esto importa.
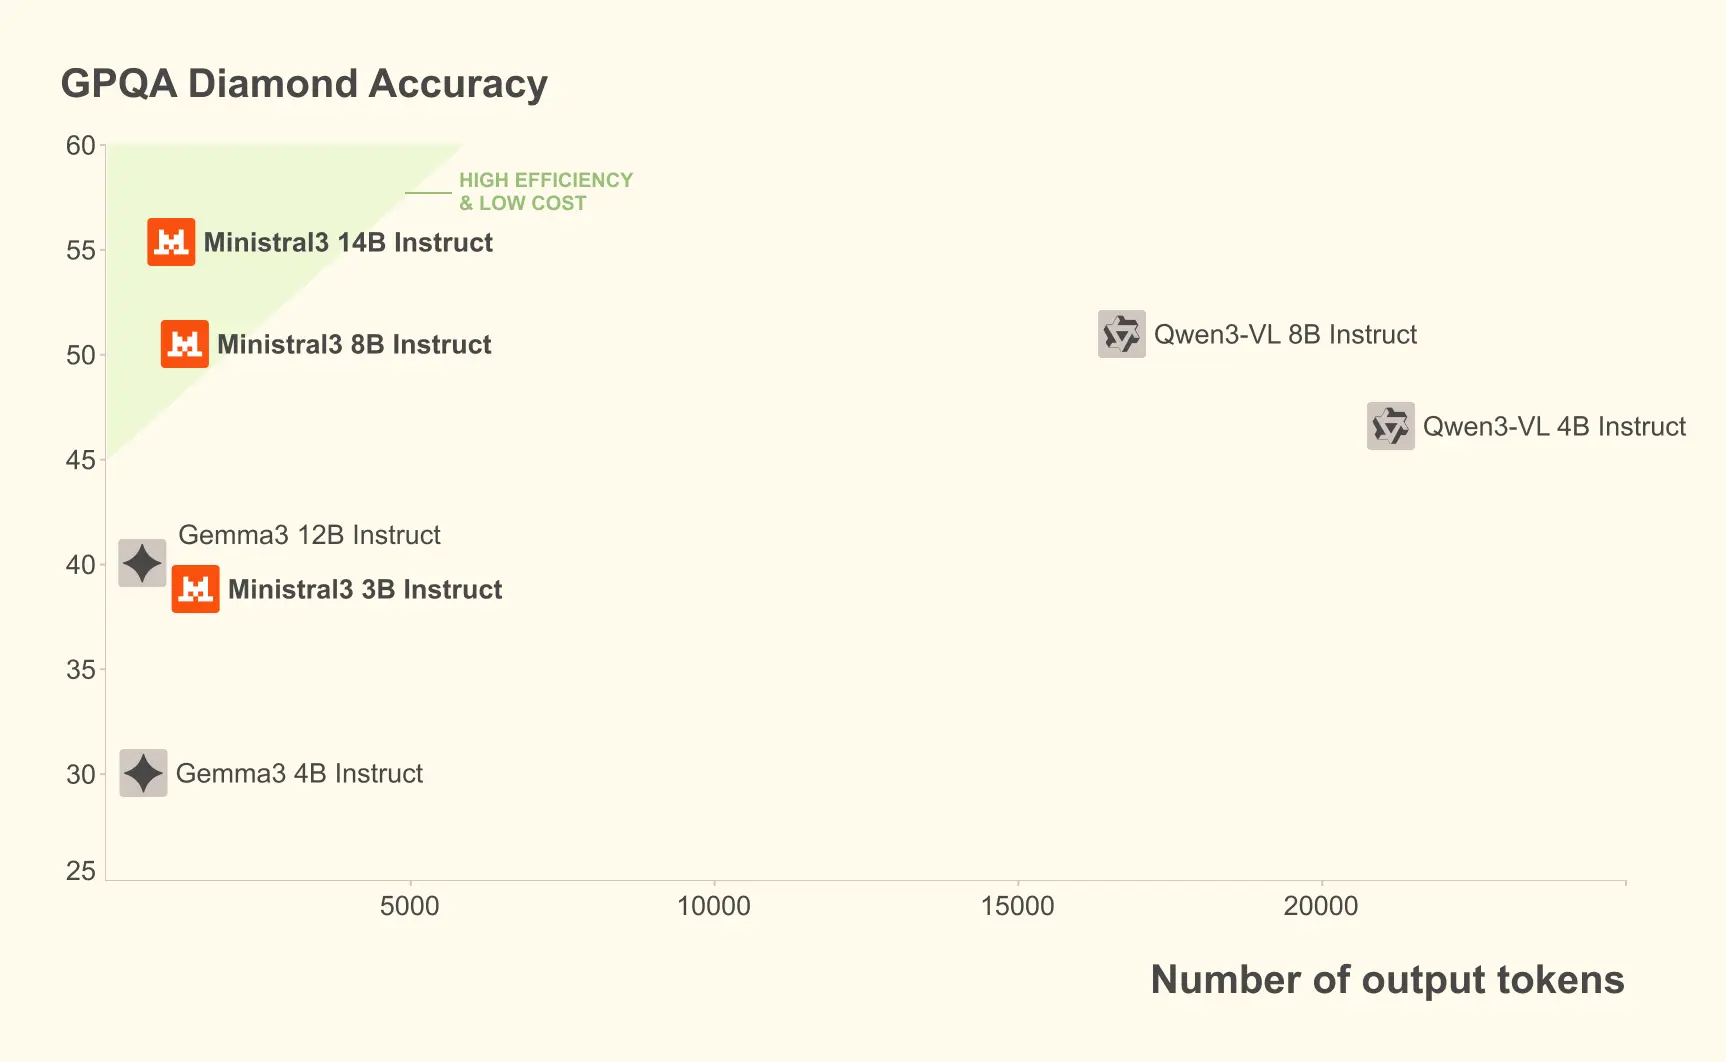
En el conjunto GPQA Diamond (una prueba rigurosa de razonamiento científico), varias variantes de Ministral 3 mantienen alta precisión incluso con un número creciente de tokens de salida. Por ejemplo, el modelo Ministral 3B Instruct mantiene un 35-40% de precisión al manejar hasta 20.000 tokens, comparable a modelos más grandes como Gemma 2 9B, usando menos recursos.
¿Cuál es la arquitectura de Mistral 3?
Mistral 3 es una familia más que una sola arquitectura, pero los dos patrones arquitectónicos que necesitas entender son:
Modelos pequeños densos (Ministral 3)
- Pilas de transformadores estándar, optimizadas para eficiencia e inferencia en el edge.
- Disponibles en múltiples tamaños (3B/8B/14B) y en diferentes variantes afinadas: base, instruct y reasoning; muchas variantes incluyen soporte multimodal nativo (visión + texto) y operación de contexto largo. Los modelos Ministral se publican con pesos FP8 optimizados para mayor compacidad en algunas distribuciones.
Mixture-of-Experts disperso (Mistral Large 3)
- Arquitectura MoE: el modelo tiene muchos expertos (recuento total de parámetros enorme), pero solo se evalúa por token un subconjunto seleccionado por enrutamiento — eso ofrece mejores compensaciones escala/compute.
- Mistral Large 3 cita ~675B parámetros totales con ~41B parámetros activos durante la inferencia, reflejando este diseño MoE. El modelo se entrenó en hardware moderno de NVIDIA y se optimizó para ejecución eficiente de baja precisión (NVFP4/TensorRT/optimizaciones de kernel grande).
Características técnicas que importan al ejecutar localmente:
- Contexto largo: algunas variantes de Mistral 3 admiten contextos muy largos (la documentación de vLLM y Mistral menciona ventanas de contexto masivas para ciertas variantes; p. ej., 256k en algunas variantes de Ministral). Eso afecta los patrones de memoria y servicio.
- Formatos de pesos y cuantización: Mistral ofrece pesos en formatos comprimidos/optimizados (FP8, NVFP4) y funciona con cadenas de herramientas de cuantización modernas (BitsAndBytes, GPTQ, herramientas del proveedor) para una inferencia local práctica.
¿Por qué ejecutarías Mistral 3 localmente?
Ejecutar LLMs localmente ya no es un hobby de nicho — es una opción práctica para equipos e individuos que se preocupan por:
- Privacidad de datos y cumplimiento. El alojamiento local mantiene las entradas sensibles dentro de tu infraestructura (importante para finanzas, salud, legal). Reuters informó de clientes de alto perfil que eligieron autoalojar modelos de Mistral.
- Latencia y control de costos. Para SLO estrictos de latencia y costos predecibles, la inferencia local o en clústeres privados puede superar las sorpresas de factura de API en la nube. Las variantes Ministral más pequeñas y los formatos cuantizados lo hacen práctico.
- Personalización y fine-tuning. Cuando necesitas comportamiento a medida, function calling o nuevas modalidades, el control local permite fine-tuning y gestión de datos personalizados. La integración con Hugging Face y vLLM lo hace más sencillo.
Si esas razones se alinean con tus prioridades — privacidad, control, previsibilidad de costos o investigación — el despliegue local merece la pena.
¿Cómo puedes ejecutar Mistral 3 localmente (tres métodos prácticos)?
Hay muchas formas de ejecutar Mistral 3 localmente. Cubriré tres enfoques que abarcan los escenarios de uso más comunes:
- Ollama (escritorio/servidor local sin configuración, lo más fácil para muchos usuarios)
- Hugging Face Transformers + PyTorch / vLLM (control total, clústeres GPU)
- llama.cpp / ggml / inferencia en CPU con GGUF cuantizado (ligero, corre en portátiles/CPU)
Para cada método listaré cuándo tiene sentido, los prerrequisitos, comandos paso a paso y pequeños ejemplos de código.
1) ¿Cómo ejecutar Mistral 3 con Ollama (la vía más rápida)?
Cuándo usar esto: quieres una experiencia local sin fricciones (macOS/Linux/Windows), una CLI o GUI accesible y descargas automáticas/artefactos cuantizados cuando estén disponibles. Ollama tiene entradas de modelos para Ministral 3 y otros miembros de la familia Mistral.
Prerrequisitos
- Ollama instalado (sigue el instalador en ollama.com). La biblioteca de Ollama indica versiones mínimas específicas para algunos lanzamientos de Ministral.
- Suficiente espacio en disco para almacenar los artefactos del modelo (los tamaños difieren — las versiones cuantizadas de Ministral 3B pueden ocupar unos GB; las variantes BF16 más grandes ocupan muchas decenas de GB).
Pasos (ejemplo)
- Instala Ollama (ejemplo macOS — adapta según la plataforma):
# macOS (Homebrew) example — see ollama.com for platform-specific installersbrew install ollama
- Ejecuta un modelo Ministral:
# Pull and run the model interactivelyollama run ministral-3
- Sirve localmente (API) y llama desde código:
# Run Ollama server (default port shown in docs)ollama serve# Then curl against it (example)curl -s -X POST "http://localhost:11434/api/v1/generate" \ -H "Content-Type: application/json" \ -d '{"model":"ministral-3","prompt":"Summarize Mistral 3 in one sentence."}'
Notas y consejos
- Ollama gestiona la descarga del modelo y (cuando está disponible) variantes cuantizadas locales — muy conveniente para probar modelos rápidamente.
- Si planeas usar el modelo en producción con muchas solicitudes concurrentes, Ollama es excelente para prototipado, pero evalúa el escalado y la orquestación de recursos para carga sostenida.
2) ¿Cómo ejecutar Mistral 3 con Hugging Face Transformers (GPU / integración con vLLM)?
Cuándo usar esto: necesitas control programático para investigación o producción, quieres hacer fine-tuning o usar pilas de inferencia aceleradas como vLLM en clústeres GPU. Hugging Face ofrece soporte en Transformers y Mistral proporciona puntos de control optimizados para vLLM/NVIDIA.
Prerrequisitos
- GPU con memoria suficiente (varía según el modelo y la precisión). Los Ministral 3 pequeños (3B/8B) pueden ejecutarse en una sola GPU de gama media cuando están cuantizados; las variantes más grandes requieren múltiples H100/A100 o puntos de control NVFP4 optimizados para vLLM. La documentación de NVIDIA y Mistral recomienda tamaños de nodo específicos para los modelos grandes.
- Python, PyTorch, transformers, accelerate (o vLLM si quieres ese servidor).
Ejemplo en Python — pipeline básico de Hugging Face (variante 3B instruct, GPU):
# Example: CPU/GPU inference with transformers pipeline# Assumes you have CUDA and a compatible PyTorch build.import torchfrom transformers import pipelinemodel_name = "mistralai/Ministral-3-3B-Instruct-2512-BF16" # example HF model idgenerator = pipeline( "text-generation", model=model_name, device_map="auto", torch_dtype=torch.bfloat16, # use bfloat16 if your hardware supports it)prompt = "Explain how attention helps transformers, in 3 sentences."out = generator(prompt, max_new_tokens=120, do_sample=False)print(out[0]["generated_text"])
Usar vLLM para inferencia en GPU de producción
vLLM está diseñado para servir modelos grandes de forma eficiente, admite la familia Mistral 3 y Mistral publicó puntos de control optimizados para hardware de NVIDIA/vLLM (NVFP4/FP8) para reducir la huella de memoria y acelerar. Iniciar un servidor vLLM te da un endpoint de inferencia de baja latencia y con batching. Consulta las recetas de vLLM y la guía de Mistral para rutas de modelo y flags recomendados.
Notas y consejos
- Para producción, prefiere puntos de control optimizados (NVFP4/FP8) y ejecuta en GPUs recomendadas (p. ej., H100/A100) o usa una capa de orquestación que admita paralelismo de tensores/modelos. Mistral y NVIDIA tienen documentación y artículos sobre tiempos de ejecución optimizados.
- Fija siempre el punto de control exacto en disco (o un snapshot reproducible de HF) para resultados reproducibles y evitar actualizaciones silenciosas del modelo.
3) ¿Cómo ejecutar Mistral 3 en CPU con llama.cpp / modelos GGUF cuantizados?
Cuándo usar esto: necesitas inferencia local, sin conexión, en CPU (p. ej., portátil de desarrollador, entorno seguro aislado) y estás dispuesto a sacrificar algo de calidad por eficiencia de tiempo de ejecución y memoria. Este método usa ggml/llama.cpp y pesos GGUF cuantizados (q4/q5/etc.).
Prerrequisitos
- Una build GGUF cuantizada de un modelo Ministral (muchos miembros de la comunidad publican GGUF cuantizados en Hugging Face o convierten pesos BF16 a GGUF localmente). Busca variantes GGUF de
Ministral-3-3B-Instruct. - Binario de llama.cpp compilado (sigue el README del proyecto).
Cuantizar (si tienes los pesos originales) — ejemplo (conceptual)
# Example: quantize from an FP16/BF16 model to a GGUF q4_K_M (syntax depends on llama.cpp version)./quantize /path/to/original/model.bin /path/to/out.gguf q4_k_m
Ejecutar un GGUF con llama.cpp
# run interactive inference with a quantized GGUF model./main -m /path/to/ministral-3-3b-instruct.gguf -t 8 -c 2048 --interactive# -t sets threads, -c sets context (tokens) if supported
Ejemplo de cliente en Python (servidor local de llama.cpp o subproceso)
Puedes iniciar llama.cpp como subproceso y pasarle prompts, o usar un pequeño cliente envoltorio. Muchos proyectos de la comunidad ofrecen un servidor HTTP sencillo sobre llama.cpp para integración con apps locales.
Notas y compensaciones
- La cuantización reduce VRAM y habilita inferencia en CPU pero puede bajar la calidad (leve a moderada, según el formato de cuantización). Formatos como q4_K_M o variantes q5 son compromisos comunes para uso en CPU. Publicaciones en japonés y técnicas explican los tipos Q4/Q5 y conversiones GGUF en detalle.
- Para cargas de trabajo pequeñas a medianas, GGUF + llama.cpp suele ser la forma más barata y portátil de ejecutar LLMs localmente.
¿Qué consideraciones de hardware y memoria importan?
Guía corta y práctica:
- Modelos 3B: a menudo pueden cuantizarse y ejecutarse en una CPU de portátil decente o en una sola GPU con 8–16 GB de VRAM (según la precisión/cuántización). Las variantes GGUF q4 pueden correr en muchas CPUs modernas.
- Ministral 8B y 14B: normalmente necesitan una GPU de gama media (p. ej., 24–80 GB según precisión y caché de activaciones) o cuantización en múltiples dispositivos.
- Mistral Large 3 (675B total, 41B activos): pensado para despliegue en centros de datos y suele funcionar mejor con nodos multi-GPU (p. ej., 8×A100 o H100) y formatos especializados (NVFP4/FP8) para vLLM. Mistral publicó explícitamente puntos de control optimizados para hacer viables esos despliegues.
Si tu prioridad es uso local en portátil, apunta a la ruta Ministral 3B cuantizado GGUF + llama.cpp. Si tu prioridad es rendimiento de producción, mira vLLM + puntos de control NVFP4 en GPUs. Si quieres facilidad de experimentación, Ollama es la forma más rápida de empezar.
¿Cómo deberías elegir cuantización y precisión?
La cuantización es una compensación: memoria y velocidad vs. calidad bruta del modelo. Opciones comunes:
- q4_0 / q4_1 / q4_K_M: opciones populares de 4 bits usadas para inferencia en CPU; q4_K_M (variante k-means) a menudo ofrece mejor equilibrio calidad/rendimiento.
- Variantes q5 / q8 / imatrix: formatos intermedios que pueden preservar más fidelidad a costa de tamaño.
- FP16 / BF16 / FP8 / NVFP4: precisiones en GPU — BF16 y FP16 son comunes para entrenamiento/inferencia en GPUs modernas; FP8 / NVFP4 son formatos emergentes que ahorran memoria para modelos muy grandes y están soportados por tiempos de ejecución optimizados y los lanzamientos de puntos de control de Mistral.
Regla general: para ejecuciones locales en CPU elige q4_K_M o similar; para inferencia en GPU con alta fidelidad usa BF16/FP16 o FP8/NVFP4 específicos del proveedor cuando el runtime lo admita.
Conclusión — ¿deberías ejecutar Mistral 3 localmente?
Si necesitas privacidad, baja latencia o personalización, sí: la familia Mistral 3 te da una paleta amplia — modelos diminutos para CPU en el edge, modelos medianos para una sola GPU o un clúster modesto, y un sabor MoE grande para escala de centro de datos — y el ecosistema (Ollama, Hugging Face, vLLM, llama.cpp) ya admite patrones prácticos de despliegue local y privado. Mistral también trabajó con NVIDIA y vLLM para proporcionar puntos de control optimizados de alto rendimiento y menor huella de memoria, lo que hace el autoalojamiento en producción más realista que antes.
Para empezar, explora más capacidades de modelos (como Gemini 3 Pro) en el Playground y consulta la guía de la API para instrucciones detalladas. Antes de acceder, asegúrate de haber iniciado sesión en CometAPI y obtenido la clave de API. CometAPI ofrece un precio muy inferior al oficial para ayudarte a integrar.
¿Listo para empezar?→ Sign up for CometAPI today !