Especificaciones técnicas de Gemini 3.6 Flash
| Elemento | Gemini 3.6 Flash |
|---|---|
| Proveedor | Google DeepMind |
| ID del modelo | gemini-3.6-flash |
| Familia de modelos | Gemini 3.x |
| Disponibilidad | Disponibilidad general (GA) |
| Tipos de entrada | Texto, Imagen, Video, Audio, PDF |
| Tipos de salida | Texto |
| Ventana de contexto | 1,048,576 tokens |
| Salida máxima | 65,536 tokens |
| Razonamiento | Compatible (medio / alto) |
| Llamada de funciones | Sí |
| Ejecución de código | Sí |
| Búsqueda de archivos | Sí |
| Contexto de URL | Sí |
| Fundamentación mediante búsqueda | Sí |
| Uso del ordenador | Vista previa |
| Salida estructurada | Sí |
| Caché | Compatible |
Fuente: Documentación de la API de Google Gemini.
¿Qué es Gemini 3.6 Flash?
Gemini 3.6 Flash es el modelo Flash más nuevo y listo para producción de Google, diseñado para ofrecer inteligencia de vanguardia manteniendo la baja latencia y la eficiencia de costos por las que se conoce la serie Flash. Está optimizado para programación, comprensión multimodal, razonamiento y flujos de trabajo agenticos.
En comparación con Gemini 3.5 Flash, el modelo mejora la calidad de generación de código, la precisión del razonamiento, el uso de herramientas y la eficiencia de tokens, al tiempo que admite una enorme ventana de contexto de 1 millón de tokens. Google lo posiciona como el modelo predeterminado de trabajo para desarrolladores que construyen agentes de IA y sistemas de automatización complejos.
Características principales de Gemini 3.6 Flash
- Admite procesamiento de contexto largo de 1M-token.
- Entradas multimodales nativas que incluyen texto, imágenes, video, audio y documentos PDF.
- Mejoras significativas en generación de código y tareas de ingeniería de software.
- Compatibilidad integrada con Llamada de funciones, Búsqueda de archivos, Contexto de URL, Fundamentación mediante búsqueda y Uso del ordenador.
- Más eficiente en tokens que Gemini 3.5 Flash, reduciendo el costo de inferencia mientras mantiene mayor calidad.
- Diseñado para agentes de IA de múltiples pasos y flujos de trabajo autónomos.
Rendimiento en benchmarks
Google informa que Gemini 3.6 Flash ofrece un rendimiento más sólido en programación, razonamiento y multimodal que Gemini 3.5 Flash, usando significativamente menos tokens de salida. La compañía destaca el rendimiento mejorado en benchmarks internos de programación y agentes, y afirma que el modelo puede reducir el uso de tokens de salida hasta en 65% en ciertas evaluaciones de ingeniería de software como DeepSWE, disminuyendo los costos generales de inferencia. Google no ha publicado tablas de benchmarks públicas y completas (por ejemplo, MMLU, GPQA, SWE-bench Verified) para este lanzamiento.
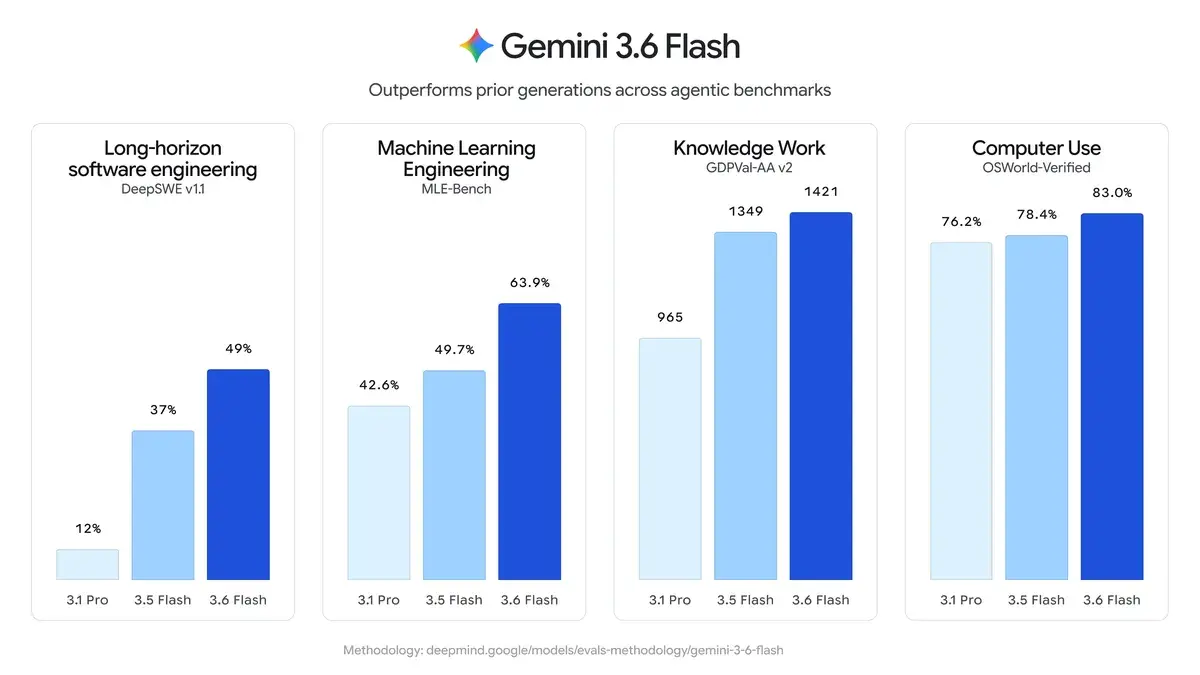
Gemini 3.6 Flash vs Gemini 3.5 Flash vs Gemini 3.1 Pro
| Aspecto | Gemini 3.6 Flash | Gemini 3.5 Flash | Gemini 3.1 Pro |
|---|---|---|---|
| Lanzamiento | 21 de julio de 2026 (GA) | A principios de 2026 | ~feb 2026 (Vista previa) |
| Posicionamiento | Caballo de batalla eficiente para agentes, programación, multimodal | Modelo Flash agentico anterior | Razonamiento avanzado de nivel Pro |
| Precios (por 1M tokens) | Entrada: $1.50Salida: $7.50 | Entrada: $1.50Salida: $9.00 | Más alto (p. ej., ~$2 entrada / $12 salida) |
| Eficiencia de tokens | 17% menos tokens de salida vs 3.5 Flash; menos pasos/llamadas a herramientas | Referencia | Menos eficiente en flujos agenticos |
| Velocidad | Alta (familia Flash) | Alta | Más lento que los modelos Flash |
| Ventana de contexto | 1M tokens | 1M tokens | Probablemente similar |
| Fortalezas | Programación, trabajo con conocimiento, multimodal (gráficos/documentos), uso de ordenador, eficiencia agentica | Buen equilibrio agente/programación | Razonamiento más profundo en problemas complejos |
Resumen rápido
- 3.6 Flash → Mejor opción general para la mayoría de usuarios en este momento: más rápido, más barato por tarea, más eficiente que 3.5 Flash y supera a 3.1 Pro en muchos benchmarks prácticos/agenticos.
- 3.5 Flash → Predecesor sólido; sigue siendo capaz pero está siendo superado por 3.6 Flash (mayor costo de tokens de salida, menos eficiente).
- 3.1 Pro → Más fuerte en algunos escenarios de razonamiento profundo, pero más lento, más caro y generalmente queda atrás de los modelos Flash más nuevos en velocidad, eficiencia y muchas tareas reales/agenticas.
Limitaciones
- La generación de imágenes no está soportada directamente.
- La generación de audio no está disponible.
- El Uso del ordenador sigue en Vista previa.
- Algunos parámetros de generación heredados (
temperature,top_p,top_k) se han eliminado de la nueva interfaz de la API. - El mejor rendimiento se logra a través de la última Gemini Interactions API.
Cómo acceder a la API de Gemini 3.6 Flash
Paso 1: Obtener acceso a la API
Inicie sesión en cometAPI. Si aún no es nuestro usuario, regístrese primero. Inicie sesión en su Consola de CometAPI. Obtenga la clave API de credenciales de acceso de la interfaz. Haga clic en “Add Token” en el token de API en el centro personal, obtenga la clave de token: sk-xxxxx y envíe.
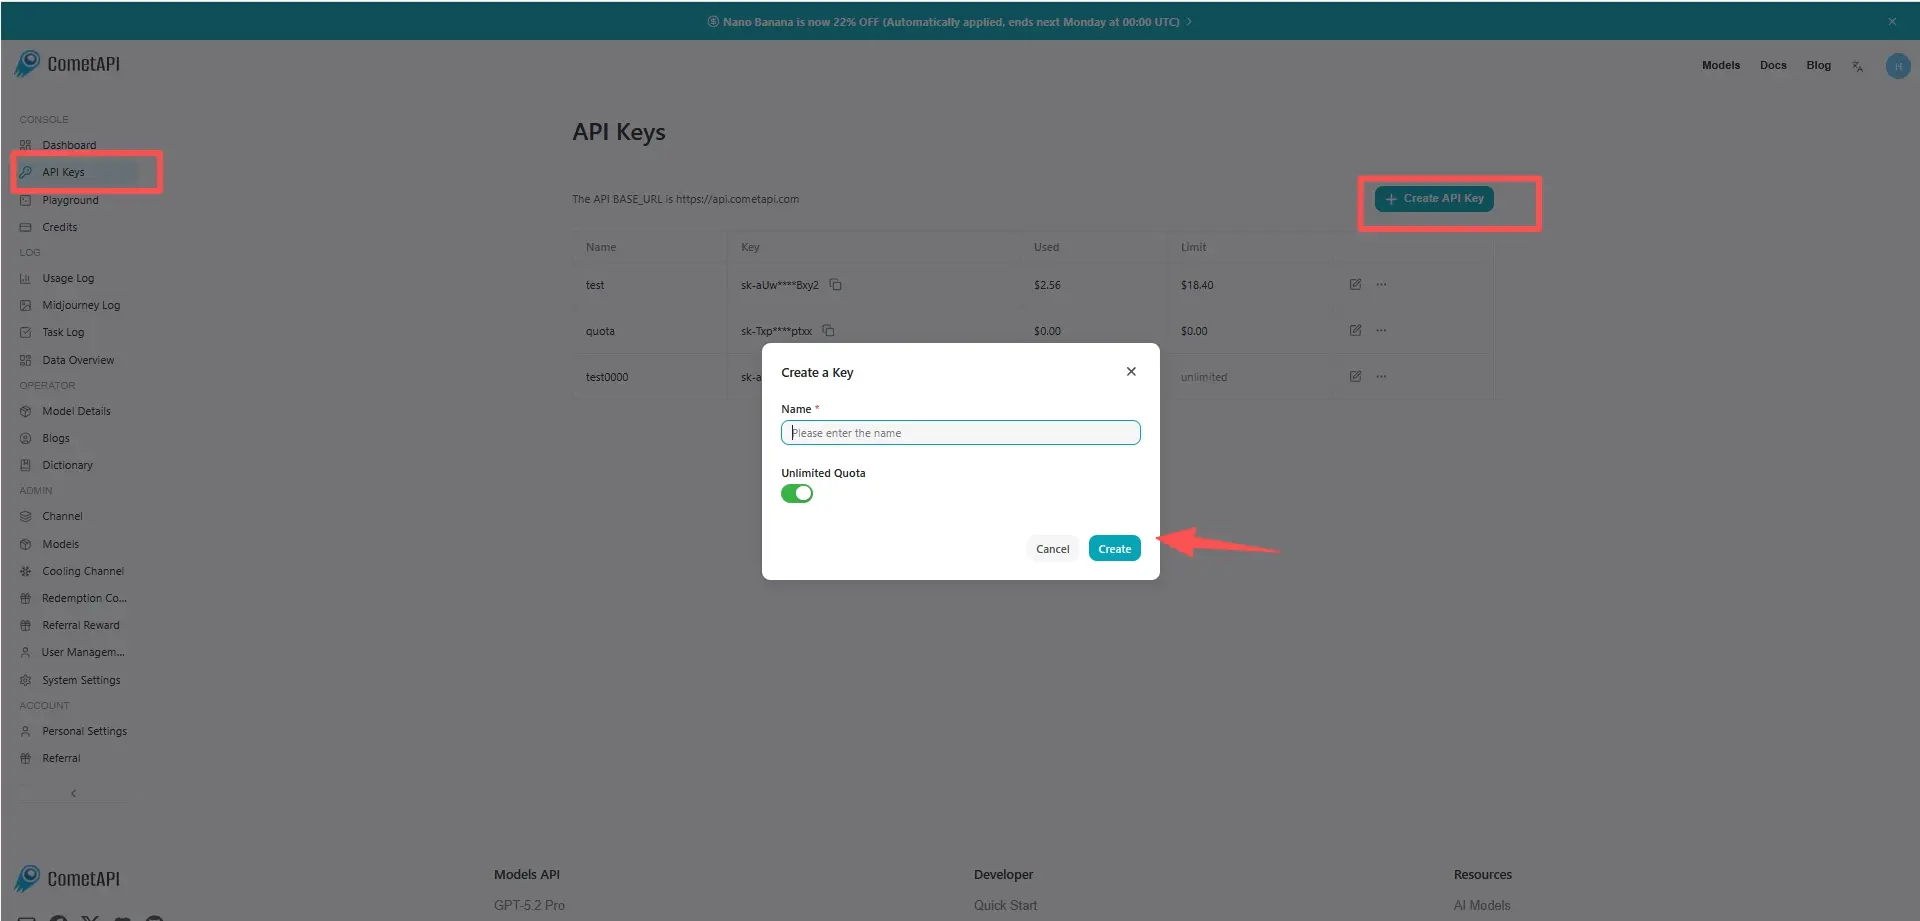
Paso 2: Enviar solicitudes a la API de Gemini 3.6 Flash
Seleccione el endpoint “ gemini-3.6-flash" "gemini-3.6-flash-thinking” para enviar la solicitud de API y configure el cuerpo de la solicitud. El método de solicitud y el cuerpo de la solicitud se obtienen de la documentación de API de nuestro sitio web. Nuestro sitio también ofrece pruebas en Apifox para su conveniencia. Reemplace <YOUR_API_KEY> con su clave real de CometAPI de su cuenta. La URL base es Generación de contenido de Gemini
Inserte su pregunta o solicitud en el campo de contenido—esto es a lo que el modelo responderá . Procese la respuesta de la API para obtener la respuesta generada.
Paso 3: Procesar respuestas
La API devuelve respuestas de candidatos estructuradas que incluyen texto generado, citas, metadatos de seguridad y salidas opcionales de herramientas.