Especificaciones técnicas de GLM-5.2
| Elemento | GLM-5.2 |
|---|---|
| Proveedor | Zhipu AI |
| Fecha de lanzamiento | 13 de junio de 2026 |
| Tipo de modelo | LLM de Mixture-of-Experts (MoE) de pesos abiertos |
| Parámetros totales | ~744B |
| Parámetros activos | ~40B por token |
| Ventana de contexto | 1,000,000 tokens |
| Salida máxima | 131,072 tokens |
| Modos de razonamiento | High, Max |
| Licencia | MIT |
| Enfoque principal | Programación basada en agentes, ingeniería de software, razonamiento a largo plazo |
| Disponibilidad de API | plataforma Z.ai y proveedores compatibles |
| Pesos abiertos | Sí |
GLM-5.2 es el último modelo insignia de la familia GLM de Zhipu AI. A diferencia de los modelos de propósito general de vanguardia, GLM-5.2 se posiciona principalmente como un modelo orientado al código y a agentes, diseñado para ingeniería de software a escala de repositorio, flujos de trabajo autónomos y razonamiento con contextos extremadamente largos. Su capacidad principal es una ventana de contexto nativa de 1 millón de tokens, lo que la convierte en una de las ventanas de contexto más grandes disponibles públicamente entre los modelos de pesos abiertos.
Principales características de GLM-5.2
- Ventana de contexto de 1M tokens para repositorios completos, conjuntos extensos de documentación y flujos de trabajo de agentes de múltiples sesiones.
- Optimización prioritaria para el código, centrada en refactorización, depuración, generación de código y tareas de ingeniería de software.
- Compatibilidad con flujos de trabajo basados en agentes para herramientas como Claude Code, Cline, Roo Code, OpenCode y agentes de programación similares.
- Publicación de pesos abiertos bajo licencia MIT, que permite el autoalojamiento y el ajuste fino.
- Dos modos de razonamiento (High y Max) que permiten equilibrar la latencia y la profundidad del razonamiento.
- Gran arquitectura MoE con aproximadamente 744B de parámetros totales, activando solo ~40B por token para mayor eficiencia.
Desempeño en benchmarks de GLM-5.2
Zhipu no publicó resultados oficiales exhaustivos de benchmarks en el lanzamiento, lo que hace que la comparación directa sea más incierta que con modelos como GPT-5 o Claude. Varios informes del sector señalan la ausencia de publicaciones de benchmarks validadas de forma independiente.
| Benchmark | Puntuación informada |
|---|---|
| Terminal-Bench 2.1 | 81.0 |
| SWE-Bench Pro | 62.1 |
| NL2Repo | 48.9 |
| AIME 2026 | 99.2 |
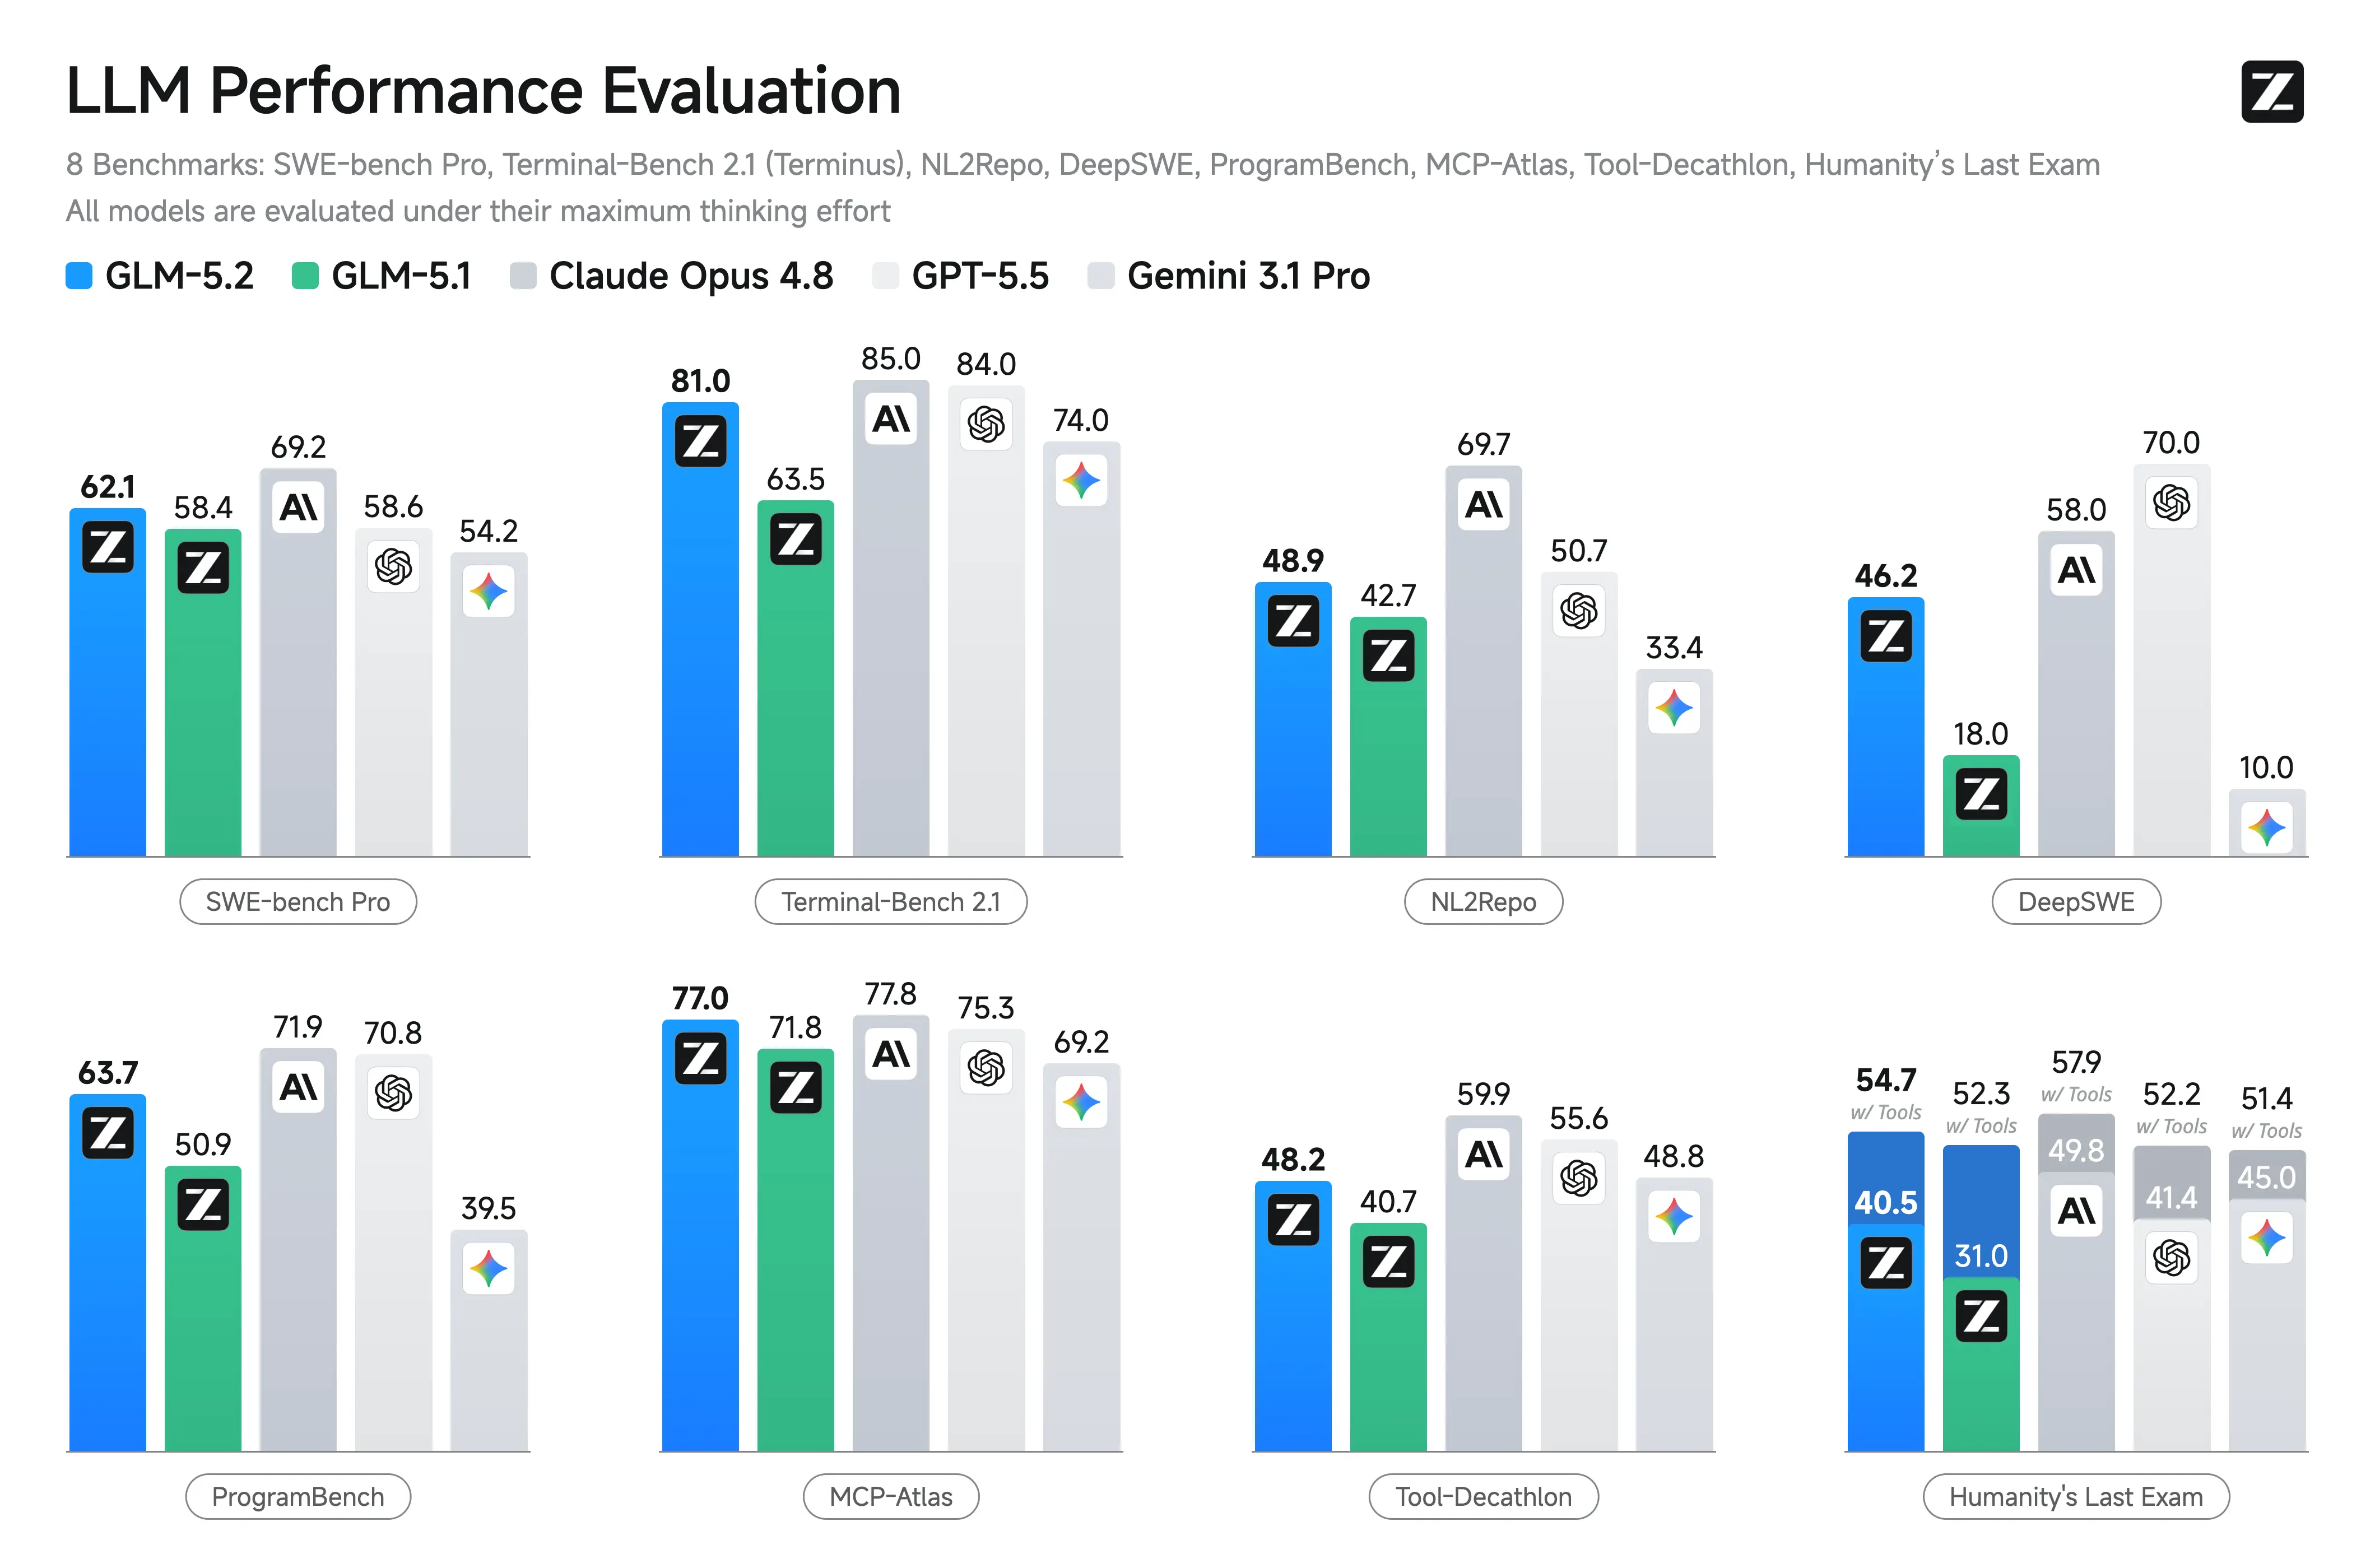
GLM-5.2 vs GLM-5.1 vs Claude Opus 4.8
| Especificación | GLM-5.2 | GLM-5.1 | Claude Opus 4.8 |
|---|---|---|---|
| Fecha de lanzamiento | 2026-06-13 | 2026 | 2026 |
| Ventana de contexto | 1,000,000 | ~200,000 | 1,000,000 |
| Pesos abiertos | Sí (MIT) | Sí | No |
| Modos de razonamiento | High, Max | Estándar | Pensamiento ampliado |
| Parámetros totales | 744B | 744B | No revelado |
| Parámetros activos | 40B | 40B | No revelado |
| Datos oficiales de benchmarks | No publicados | Publicados en el lanzamiento | Publicados |
La principal mejora documentada de GLM-5.2 sobre GLM-5.1 es su ampliación a una ventana de contexto de 1M tokens y la introducción de modos de razonamiento seleccionables High y Max. En el lanzamiento, Z.ai no publicó resultados oficiales de SWE-Bench, LiveCodeBench, HumanEval u otros benchmarks similares, por lo que las comparaciones de rendimiento frente a Claude Opus 4.8, GPT-5, DeepSeek o modelos Qwen siguen sin verificarse.
En comparación con otros modelos abiertos, el principal diferenciador de GLM-5.2 es la combinación de una ventana de contexto muy grande, especialización en programación y la licencia MIT. Su mayor atractivo es para la ingeniería de software a escala de repositorio más que para aplicaciones de chat generales.
¿Por qué usar GLM-5.2 a través de CometAPI?
CometAPI permite a los desarrolladores integrar GLM-5.2 utilizando la misma interfaz empleada para decenas de modelos de IA líderes.
Entre los beneficios se incluyen:
- Autenticación unificada entre múltiples proveedores
- Integración de API compatible con OpenAI
- Facturación y gestión de uso simplificadas
- Experimentación rápida con modelos alternativos
- Cambio sencillo entre modelos de código, razonamiento, imagen, audio y video
- Menor dependencia del proveedor en sistemas de producción
Tanto si está creando un IDE de IA, un asistente de ingeniería interno o una plataforma de automatización empresarial, CometAPI minimiza el esfuerzo de integración a la vez que preserva la flexibilidad.
Cómo acceder a la API de GLM-5.2 en CometAPI
Empiece con nuestro producto en solo unos sencillos pasos...
Paso 1: Regístrese para obtener su clave de API de GLM-5.2
Cree una cuenta en CometAPI y vaya al panel de API para generar su clave de API de GLM-5.2. Esta clave autentica todas sus solicitudes y le da acceso inmediato a todas las capacidades de la API de GLM-5.2, incluida la ventana de contexto de 1M tokens y 128k tokens de salida.
Paso 2: Envíe solicitudes a la API de GLM-5.2
Use su clave de API de GLM-5.2 para enviar solicitudes POST al endpoint de CometAPI. Pase su prompt, establezca parámetros del modelo como el nivel de esfuerzo y el máximo de tokens, y la API de GLM-5.2 procesará su solicitud, ocupándose de todo, desde la generación de código hasta el análisis de documentos y el uso de herramientas por agentes.
Paso 3: Recupere resultados e integre la API de GLM-5.2
La API de GLM-5.2 entrega respuestas estructuradas, incluyendo texto de finalización, instrucciones de llamada a herramientas y metadatos de uso de tokens. Admite respuestas sincrónicas estándar y transmisión en tiempo real mediante Server-Sent Events (SSE) cuando stream: true está configurado. El endpoint puede integrarse fácilmente en sus flujos de trabajo existentes usando clientes HTTP estándar o SDK compatibles con OpenAI, enrutando las solicitudes a través de url(//api.cometapi.com/v1) con su Bearer Token.