Specifiche tecniche di Gemini 3.6 Flash
| Elemento | Gemini 3.6 Flash |
|---|---|
| Fornitore | Google DeepMind |
| ID modello | gemini-3.6-flash |
| Famiglia del modello | Gemini 3.x |
| Disponibilità | Disponibilità generale (GA) |
| Tipi di input | Text, Image, Video, Audio, PDF |
| Tipi di output | Text |
| Finestra di contesto | 1,048,576 tokens |
| Output massimo | 65,536 tokens |
| Thinking | Supportato (medium / high) |
| Function calling | Yes |
| Code execution | Yes |
| File Search | Yes |
| URL Context | Yes |
| Search Grounding | Yes |
| Computer Use | Anteprima |
| Structured Output | Yes |
| Caching | Supportato |
Fonte: documentazione dell'API Google Gemini.
Che cos'è Gemini 3.6 Flash?
Gemini 3.6 Flash è il più recente modello Flash di produzione di Google, progettato per offrire intelligenza di frontiera mantenendo al contempo la bassa latenza e l’efficienza dei costi per cui la serie Flash è nota. È ottimizzato per coding, comprensione multimodale, ragionamento e flussi di lavoro agentici.
Rispetto a Gemini 3.5 Flash, il modello migliora la qualità della generazione di codice, l’accuratezza del ragionamento, l’uso degli strumenti e l’efficienza dei token, supportando al contempo un’enorme finestra di contesto da 1 milione di token. Google lo posiziona come il modello “cavallo di battaglia” predefinito per gli sviluppatori che costruiscono agenti IA e sistemi di automazione complessi.
Caratteristiche principali di Gemini 3.6 Flash
- Supporta l’elaborazione di contesti lunghi da 1M-token.
- Input multimodali nativi, inclusi testo, immagini, video, audio e documenti PDF.
- Miglioramenti significativi nella generazione di codice e nei compiti di ingegneria del software.
- Supporto integrato per Function Calling, File Search, URL Context, Search Grounding e Computer Use.
- Più efficiente in termini di token rispetto a Gemini 3.5 Flash, riducendo i costi di inferenza mantenendo una qualità superiore.
- Progettato per agenti IA multi‑passo e flussi di lavoro autonomi.
Prestazioni nei benchmark
Google riporta che Gemini 3.6 Flash offre prestazioni superiori in coding, ragionamento e multimodalità rispetto a Gemini 3.5 Flash, utilizzando significativamente meno token di output. L’azienda evidenzia miglioramenti sulle proprie suite interne per coding e compiti agentici e afferma che il modello può ridurre l’uso di token di output fino al 65% in alcune valutazioni di ingegneria del software come DeepSWE, abbassando i costi di inferenza complessivi. Google non ha pubblicato tabelle di benchmark pubbliche complete (ad es., MMLU, GPQA, SWE-bench Verified) per questa release.
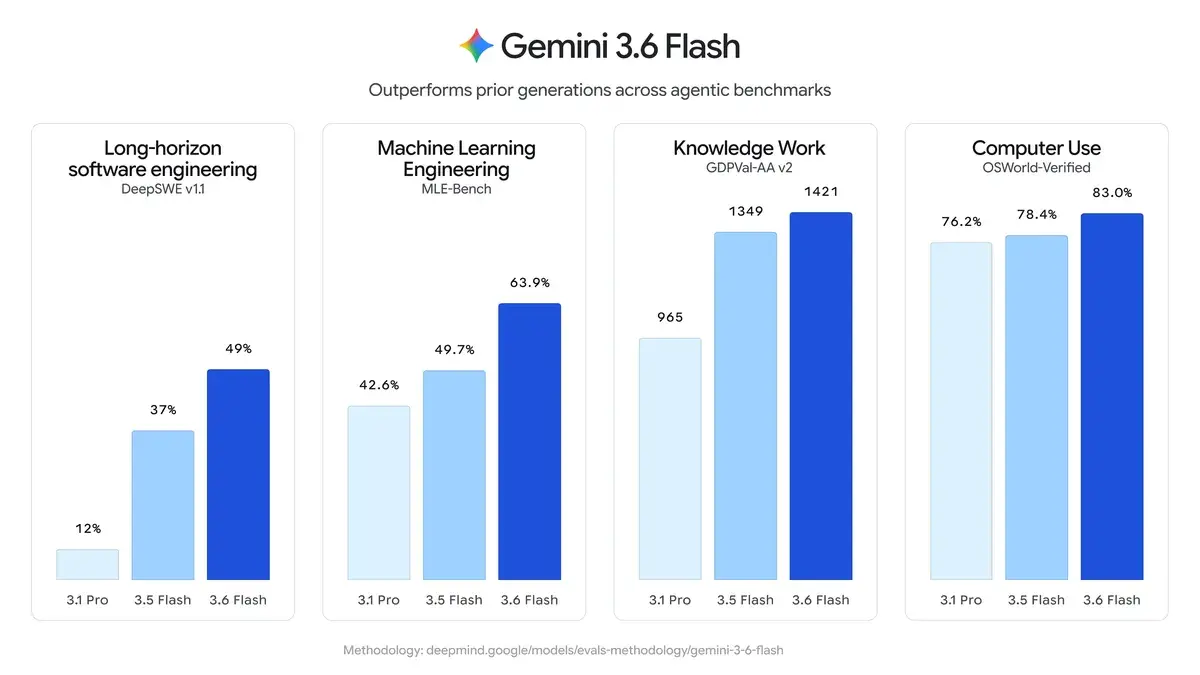
Gemini 3.6 Flash vs Gemini 3.5 Flash vs Gemini 3.1 Pro
| Aspetto | Gemini 3.6 Flash | Gemini 3.5 Flash | Gemini 3.1 Pro |
|---|---|---|---|
| Rilascio | 21 luglio 2026 (GA) | All'inizio del 2026 | ~feb 2026 (Anteprima) |
| Posizionamento | Cavallo di battaglia efficiente per agenti, programmazione, multimodalità | Precedente modello Flash agentico | Ragionamento avanzato di livello Pro |
| Prezzi (per 1M token) | Input: $1.50Output: $7.50 | Input: $1.50Output: $9.00 | Più elevato (ad es., ~$2 input / $12 output) |
| Efficienza dei token | 17% in meno di token di output vs 3.5 Flash; meno passaggi/chiamate agli strumenti | Baseline | Meno efficiente nei flussi agentici |
| Velocità | Alta (famiglia Flash) | Alta | Più lento dei modelli Flash |
| Finestra di contesto | 1M token | 1M token | Probabilmente simile |
| Punti di forza | Programmazione, lavoro di conoscenza, multimodalità (grafici/documenti), Computer Use, efficienza agentica | Buon equilibrio agenti/programmazione | Ragionamento più profondo su problemi complessi |
Riepilogo rapido
- 3.6 Flash → La scelta migliore in assoluto per la maggior parte degli utenti: più veloce, più economico per attività, più efficiente di 3.5 Flash e supera 3.1 Pro in molti benchmark pratici/agentici.
- 3.5 Flash → Solido predecessore; ancora valido ma viene superato da 3.6 Flash (costo dei token di output più alto, meno efficiente).
- 3.1 Pro → Più forte in alcuni scenari di ragionamento profondo ma più lento, più costoso e generalmente inferiore ai modelli Flash più recenti in velocità, efficienza e molte attività reali/agentiche.
Limitazioni
- La generazione di immagini non è supportata direttamente.
- La generazione audio non è disponibile.
- Computer Use rimane in Anteprima.
- Alcuni parametri legacy di generazione (
temperature,top_p,top_k) sono stati rimossi dalla nuova interfaccia API. - Le migliori prestazioni si ottengono tramite la versione più recente della Gemini Interactions API.
Come accedere all'API di Gemini 3.6 Flash
Passaggio 1: Ottieni l’accesso all’API
Accedi a cometAPI. Se non sei ancora nostro utente, registrati prima. Accedi alla tua CometAPI console. Ottieni la chiave API di credenziale di accesso dell’interfaccia. Fai clic su “Add Token” alla voce API token nel centro personale, ottieni la chiave del token: sk-xxxxx e invia.
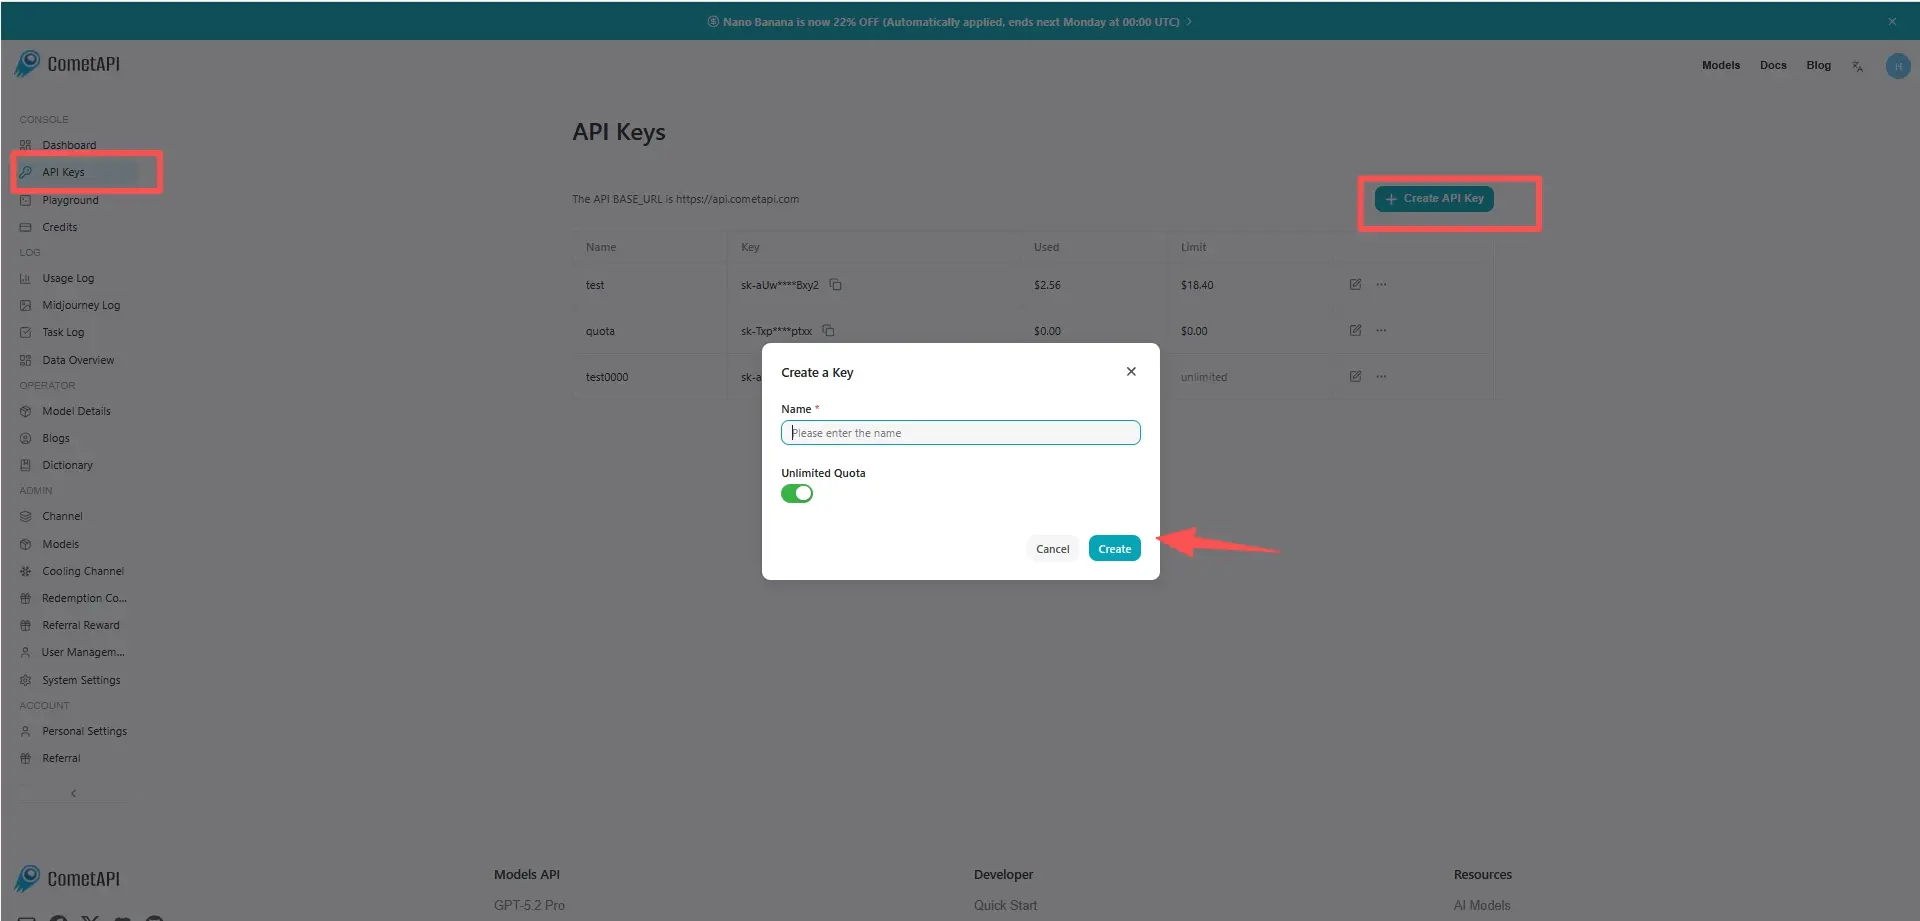
Passaggio 2: Invia richieste all’API Gemini 3.6 Flash
Seleziona l’endpoint “ gemini-3.6-flash" "gemini-3.6-flash-thinking” per inviare la richiesta API e imposta il corpo della richiesta. Il metodo e il corpo della richiesta sono reperibili nella documentazione dell’API sul nostro sito web. Il nostro sito offre anche test Apifox per tua comodità. Sostituisci <YOUR_API_KEY> con la tua chiave CometAPI effettiva del tuo account. L'URL di base è Gemini Generating Content
Inserisci la tua domanda o richiesta nel campo content—è a questo che il modello risponderà. Elabora la risposta dell’API per ottenere la risposta generata.
Passaggio 3: Elabora le risposte
L’API restituisce risposte candidate strutturate che includono testo generato, citazioni, metadati di sicurezza e output opzionali degli strumenti.