Gemini 3.6 Flash の技術仕様
| 項目 | Gemini 3.6 Flash |
|---|---|
| Provider | Google DeepMind |
| Model ID | gemini-3.6-flash |
| Model family | Gemini 3.x |
| Availability | 一般提供(GA) |
| Input types | テキスト、画像、動画、音声、PDF |
| Output types | テキスト |
| Context window | 1,048,576 トークン |
| Maximum output | 65,536 トークン |
| Thinking | 対応(中/高) |
| Function calling | あり |
| Code execution | あり |
| File Search | あり |
| URL Context | あり |
| Search Grounding | あり |
| Computer Use | プレビュー |
| Structured Output | あり |
| Caching | 対応 |
出典: Google Gemini API ドキュメント。
Gemini 3.6 Flash とは?
Gemini 3.6 Flash は、Flash シリーズの低レイテンシとコスト効率を維持しながら、最先端レベルのインテリジェンスを提供するよう設計された、Google の最新のプロダクション対応モデルです。コーディング、マルチモーダル理解、推論、エージェントワークフローに最適化されています。
Gemini 3.5 Flash と比較して、コード生成品質、推論精度、ツール利用、トークン効率が向上し、100万トークンの巨大なコンテキストウィンドウをサポートします。Google は、AI エージェントや複雑な自動化システムを構築する開発者向けのデフォルトの主力モデルとして位置付けています。
Gemini 3.6 Flash の主な機能
- 1Mトークンに対応した長文脈処理。
- テキスト、画像、動画、音声、PDF ドキュメントのネイティブなマルチモーダル入力。
- コード生成とソフトウェアエンジニアリング業務での大幅な改善。
- 関数呼び出し、ファイル検索、URL コンテキスト、検索グラウンディング、Computer Use の組み込み対応。
- Gemini 3.5 Flash よりもトークン効率が高く、品質を維持しつつ推論コストを削減。
- マルチステップの AI エージェントと自律的ワークフロー向けに設計。
ベンチマーク性能
Google は、Gemini 3.6 Flash がコーディング、推論、マルチモーダル性能で Gemini 3.5 Flash を上回り、出力トークンを大幅に削減できると報告しています。社内のコーディングおよびエージェント系ベンチマークでの改善を強調しており、DeepSWE のようなソフトウェアエンジニアリング評価では出力トークン使用量を最大 65% 削減し、全体の推論コストを下げられるとしています。なお、今回のリリースでは包括的な公開ベンチマーク表(例: MMLU、GPQA、SWE-bench Verified)は公開されていません。
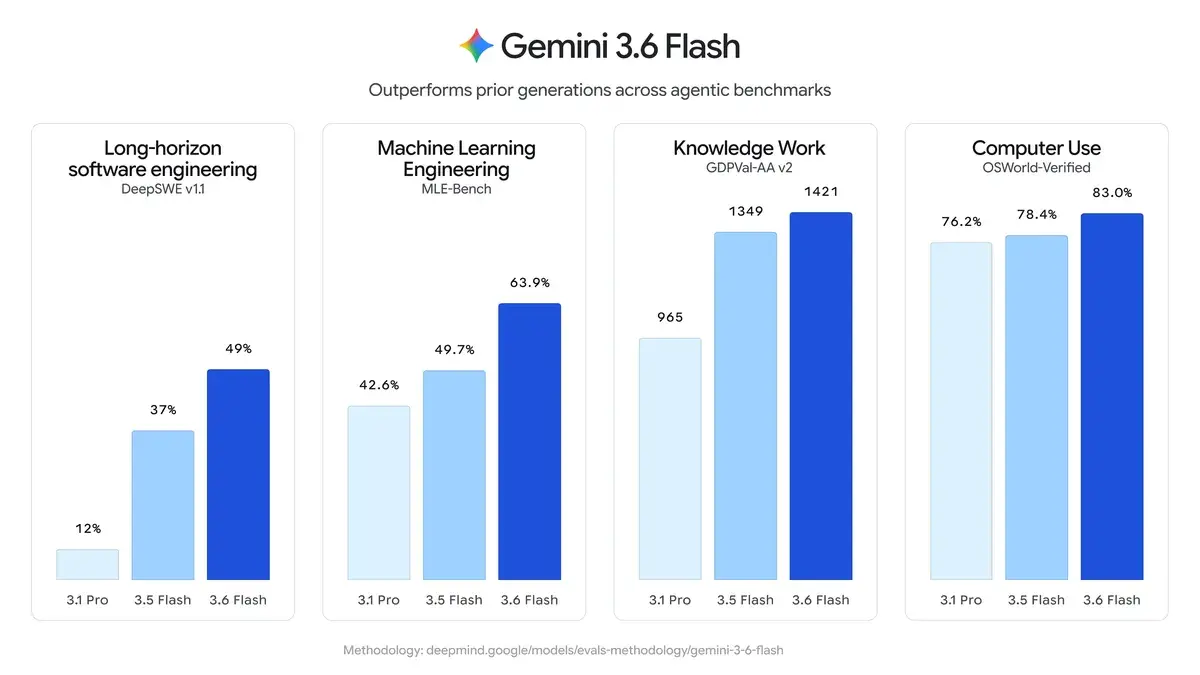
Gemini 3.6 Flash vs Gemini 3.5 Flash vs Gemini 3.1 Pro
| 項目 | Gemini 3.6 Flash | Gemini 3.5 Flash | Gemini 3.1 Pro |
|---|---|---|---|
| Release | 2026年7月21日(GA) | 2026年前半 | 約2026年2月(プレビュー) |
| Positioning | エージェント、コーディング、マルチモーダルに効率的な主力モデル | 先行のエージェント系 Flash モデル | 上位 Pro ティアの高度な推論 |
| Pricing (per 1M tokens) | 入力: $1.50出力: $7.50 | 入力: $1.50出力: $9.00 | 高め(例: 約 $2 入力 / $12 出力) |
| Token Efficiency | 3.5 Flash 比で出力トークンを17%削減;ステップ数/ツール呼び出しも少ない | 基準値 | エージェントワークフローでは効率低め |
| Speed | 高(Flash ファミリー) | 高 | Flash モデルより低速 |
| Context Window | 1M トークン | 1M トークン | 同等の可能性 |
| Strengths | コーディング、ナレッジ業務、マルチモーダル(チャート/ドキュメント)、Computer Use、エージェント効率 | エージェント/コーディングのバランス | 複雑課題でのより深い推論 |
まとめ
- 3.6 Flash → 現時点でほとんどのユーザーに最適な選択。より高速、タスクあたりのコストが安く、3.5 Flash より効率的で、多くの実用/エージェント系ベンチマークで 3.1 Pro を上回る。
- 3.5 Flash → 実績のある前世代。依然として有能だが 3.6 Flash に置き換えが進行中(出力トークンコストが高く、効率も劣る)。
- 3.1 Pro → 一部の深い推論シナリオでは強力だが、遅く高価で、速度・効率・多くの実用/エージェントタスクでは新しい Flash モデルに劣る。
制限事項
- 画像生成には直接対応していません。
- 音声生成は利用できません。
- Computer Use は引き続きプレビュー段階です。
- 旧来の生成パラメータ(
temperature、top_p、top_k)の一部が新しい API インターフェースから削除されました。 - 最高の性能は最新の Gemini Interactions API を通じて得られます。
Gemini 3.6 Flash API のアクセス方法
ステップ 1: API アクセスを取得
cometAPI にログインします。未登録の場合は、まず登録してください。 CometAPI console にサインインします。インターフェースのアクセス認証 API キーを取得します。個人センターの API トークンで「Add Token」をクリックし、トークンキー(sk-xxxxx)を取得して送信します。
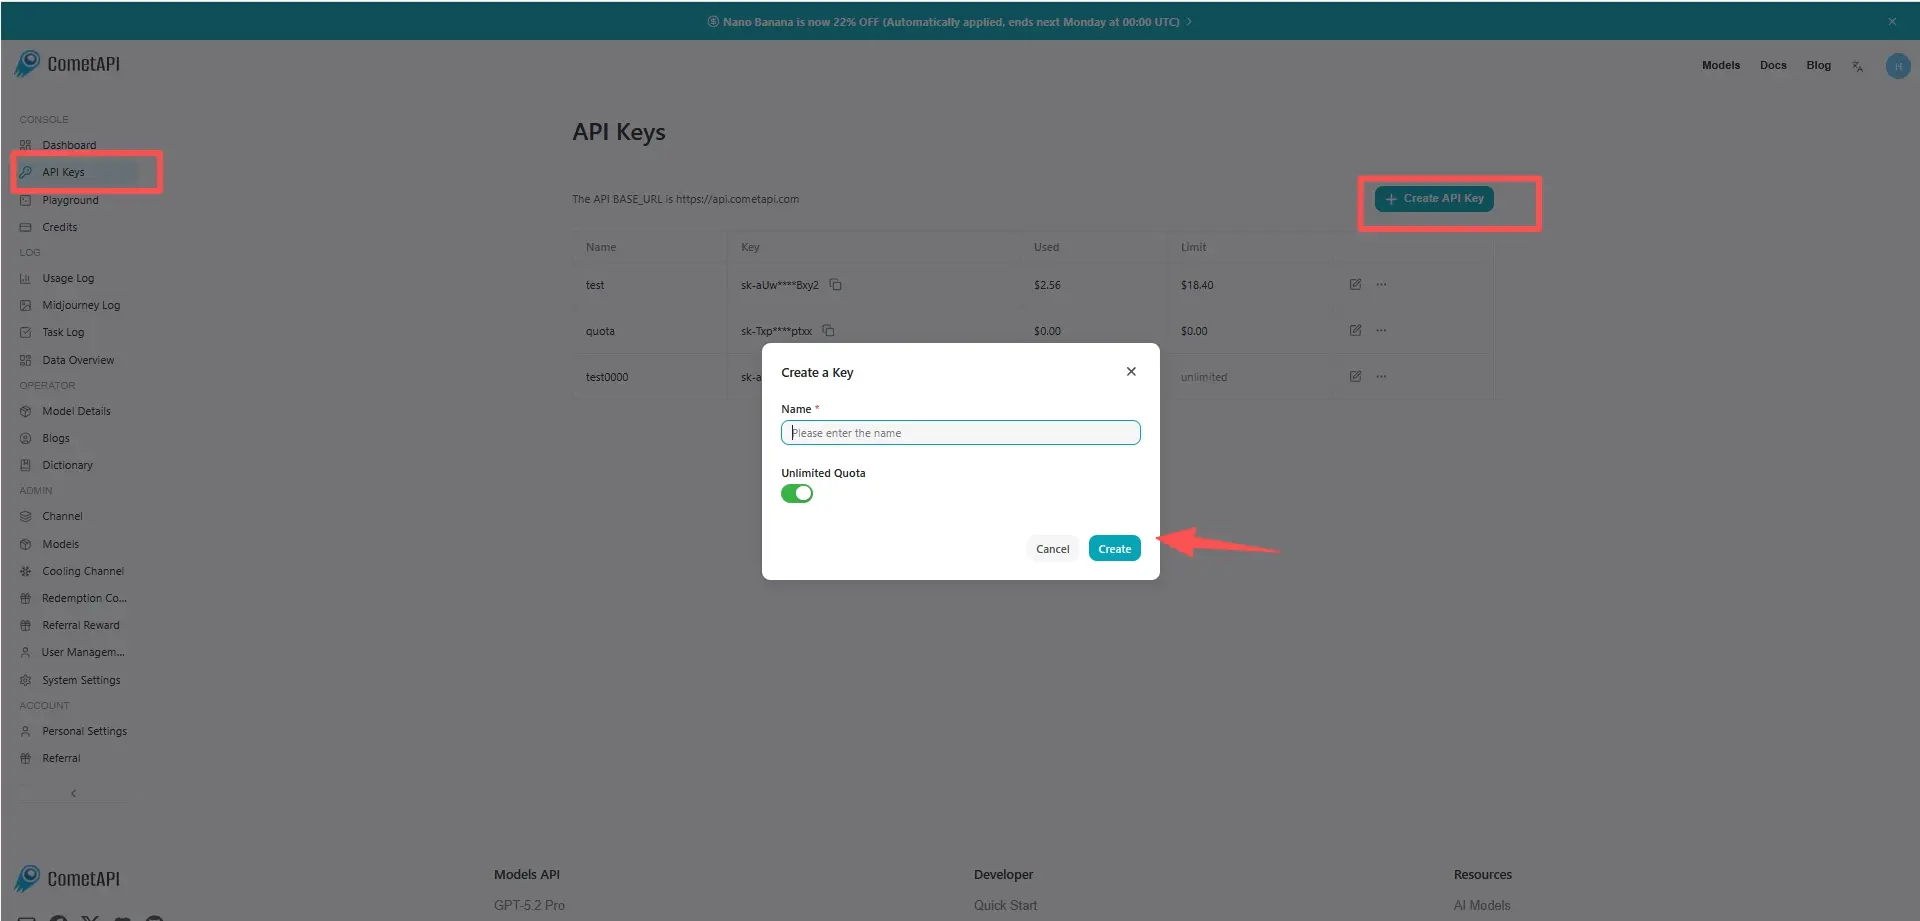
ステップ 2: Gemini 3.6 Flash API にリクエストを送信
“ gemini-3.6-flash" "gemini-3.6-flash-thinking” エンドポイントを選択して API リクエストを送信し、リクエストボディを設定します。リクエストメソッドとリクエストボディは当社ウェブサイトの API ドキュメントから取得できます。便利な Apifox テストも提供しています。<YOUR_API_KEY> をアカウントの実際の CometAPI キーに置き換えます。ベース URL は Gemini Generating Content です。
質問やリクエストを content フィールドに挿入します—モデルはこの内容に応答します。API レスポンスを処理して生成された回答を取得します。
ステップ 3: レスポンスを処理
API は、生成テキスト、引用、セーフティメタデータ、オプションのツール出力を含む構造化された候補レスポンスを返します。