Gemini 3.6 Flash 기술 사양
| 항목 | Gemini 3.6 Flash |
|---|---|
| 제공자 | Google DeepMind |
| 모델 ID | gemini-3.6-flash |
| 모델 계열 | Gemini 3.x |
| 출시 상태 | 일반 공급(GA) |
| 입력 유형 | Text, Image, Video, Audio, PDF |
| 출력 유형 | Text |
| 컨텍스트 윈도우 | 1,048,576 tokens |
| 최대 출력 | 65,536 tokens |
| Thinking | 지원됨(중간 / 높음) |
| 함수 호출 | 예 |
| 코드 실행 | 예 |
| 파일 검색 | 예 |
| URL 컨텍스트 | 예 |
| 검색 그라운딩 | 예 |
| 컴퓨터 사용 | 프리뷰 |
| 구조화 출력 | 예 |
| 캐싱 | 지원됨 |
출처: Google Gemini API 문서.
Gemini 3.6 Flash란?
Gemini 3.6 Flash는 Google의 최신 프로덕션 준비 완료 Flash 모델로, Flash 시리즈가 지닌 낮은 지연 시간과 비용 효율을 유지하면서도 프런티어 수준의 지능을 제공하도록 설계되었습니다. 코딩, 멀티모달 이해, 추론, 에이전틱(Agentic) 워크플로에 최적화되어 있습니다.
Gemini 3.5 Flash와 비교해 코드 생성 품질, 추론 정확도, 도구 사용, 토큰 효율을 개선하면서도 100만 토큰에 이르는 대규모 컨텍스트 윈도우를 지원합니다. Google은 이를 AI 에이전트와 복잡한 자동화 시스템을 구축하는 개발자를 위한 기본 워크호스 모델로 포지셔닝하고 있습니다.
Gemini 3.6 Flash의 주요 기능
- 1M-token 롱 컨텍스트 처리 지원.
- 텍스트, 이미지, 비디오, 오디오, PDF 문서를 포함한 네이티브 멀티모달 입력.
- 코드 생성 및 소프트웨어 엔지니어링 작업에서 강력한 향상.
- 함수 호출, 파일 검색, URL 컨텍스트, 검색 그라운딩, 컴퓨터 사용에 대한 내장 지원.
- Gemini 3.5 Flash보다 더 높은 토큰 효율로 추론 비용을 낮추면서 품질 유지.
- 다단계 AI 에이전트와 자율 워크플로를 위해 설계됨.
벤치마크 성능
Google은 Gemini 3.6 Flash가 Gemini 3.5 Flash 대비 코딩, 추론, 멀티모달 성능이 더 강력하며 출력 토큰 수를 크게 줄인다고 보고합니다. 내부 코딩 및 에이전틱 벤치마크에서의 향상을 강조했으며, DeepSWE와 같은 일부 소프트웨어 엔지니어링 평가에서 출력 토큰 사용량을 최대 **65%**까지 줄여 전체 추론 비용을 낮출 수 있다고 밝혔습니다. 이번 릴리스에 대해서는 MMLU, GPQA, SWE-bench Verified와 같은 포괄적인 공개 벤치마크 표가 공개되지 않았습니다.
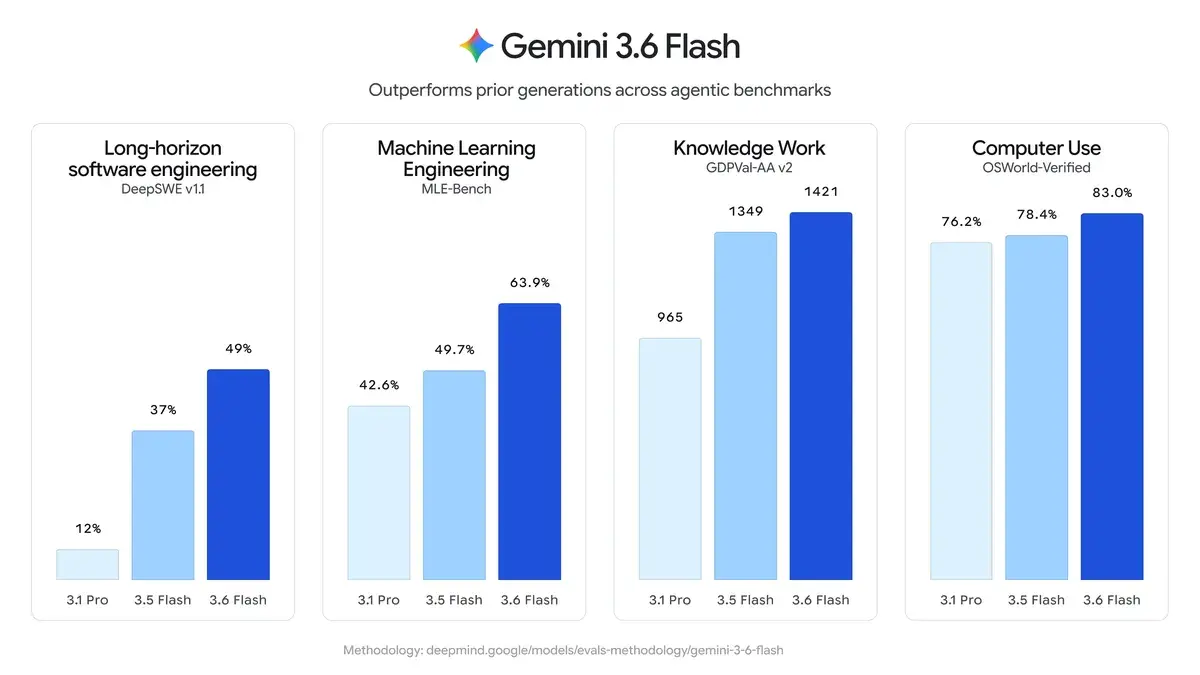
Gemini 3.6 Flash vs Gemini 3.5 Flash vs Gemini 3.1 Pro
| 측면 | Gemini 3.6 Flash | Gemini 3.5 Flash | Gemini 3.1 Pro |
|---|---|---|---|
| 릴리스 | July 21, 2026 (GA) | Earlier 2026 | ~Feb 2026 (Preview) |
| 포지셔닝 | 에이전트, 코딩, 멀티모달에 최적화된 효율적 워크호스 | 이전 에이전틱 Flash 모델 | 고급 Pro 티어의 심층 추론 |
| 가격(100만 토큰 기준) | 입력: $1.50출력: $7.50 | 입력: $1.50출력: $9.00 | 더 높음(예: ~$2 입력 / $12 출력) |
| 토큰 효율 | 3.5 Flash 대비 출력 토큰 17% 감소; 단계/도구 호출 감소 | 기준선 | 에이전틱 워크플로에서 비효율적 |
| 속도 | 높음(Flash 계열) | 높음 | Flash 모델보다 느림 |
| 컨텍스트 윈도우 | 1M tokens | 1M tokens | 유사할 가능성 |
| 강점 | 코딩, 지식 작업, 멀티모달(차트/문서), 컴퓨터 사용, 에이전틱 효율성 | 균형 잡힌 에이전틱/코딩 | 복잡한 문제에 대한 더 깊은 추론 |
빠른 요약
- 3.6 Flash → 현재 대부분의 사용자에게 최적: 더 빠르고, 작업당 비용이 저렴하며, 3.5 Flash보다 효율적이고 다수의 실용/에이전틱 벤치마크에서 3.1 Pro를 능가.
- 3.5 Flash → 견고한 전작; 여전히 유능하지만 3.6 Flash가 대체 중(출력 토큰 비용 높고 비효율적).
- 3.1 Pro → 일부 심층 추론 시나리오에서 더 강력하지만 더 느리고 더 비싸며, 속도와 효율, 많은 실제/에이전틱 작업에서 신규 Flash 모델에 뒤처짐.
제한 사항
- 이미지 생성은 직접적으로 지원되지 않음.
- 오디오 생성은 불가능.
- 컴퓨터 사용은 프리뷰 상태.
- 일부 레거시 생성 파라미터(
temperature,top_p,top_k)가 새로운 API 인터페이스에서 제거됨. - 최상의 성능은 최신 Gemini Interactions API를 통해 달성됨.
Gemini 3.6 Flash API에 접근하는 방법
1단계: API 액세스 받기
cometAPI에 로그인하세요. 아직 사용자라면 먼저 등록해 주세요. CometAPI 콘솔에 로그인합니다. 인터페이스의 액세스 자격 증명 API 키를 가져옵니다. 개인 센터의 API 토큰에서 “Add Token”을 클릭해 토큰 키: sk-xxxxx를 발급받아 제출하세요.
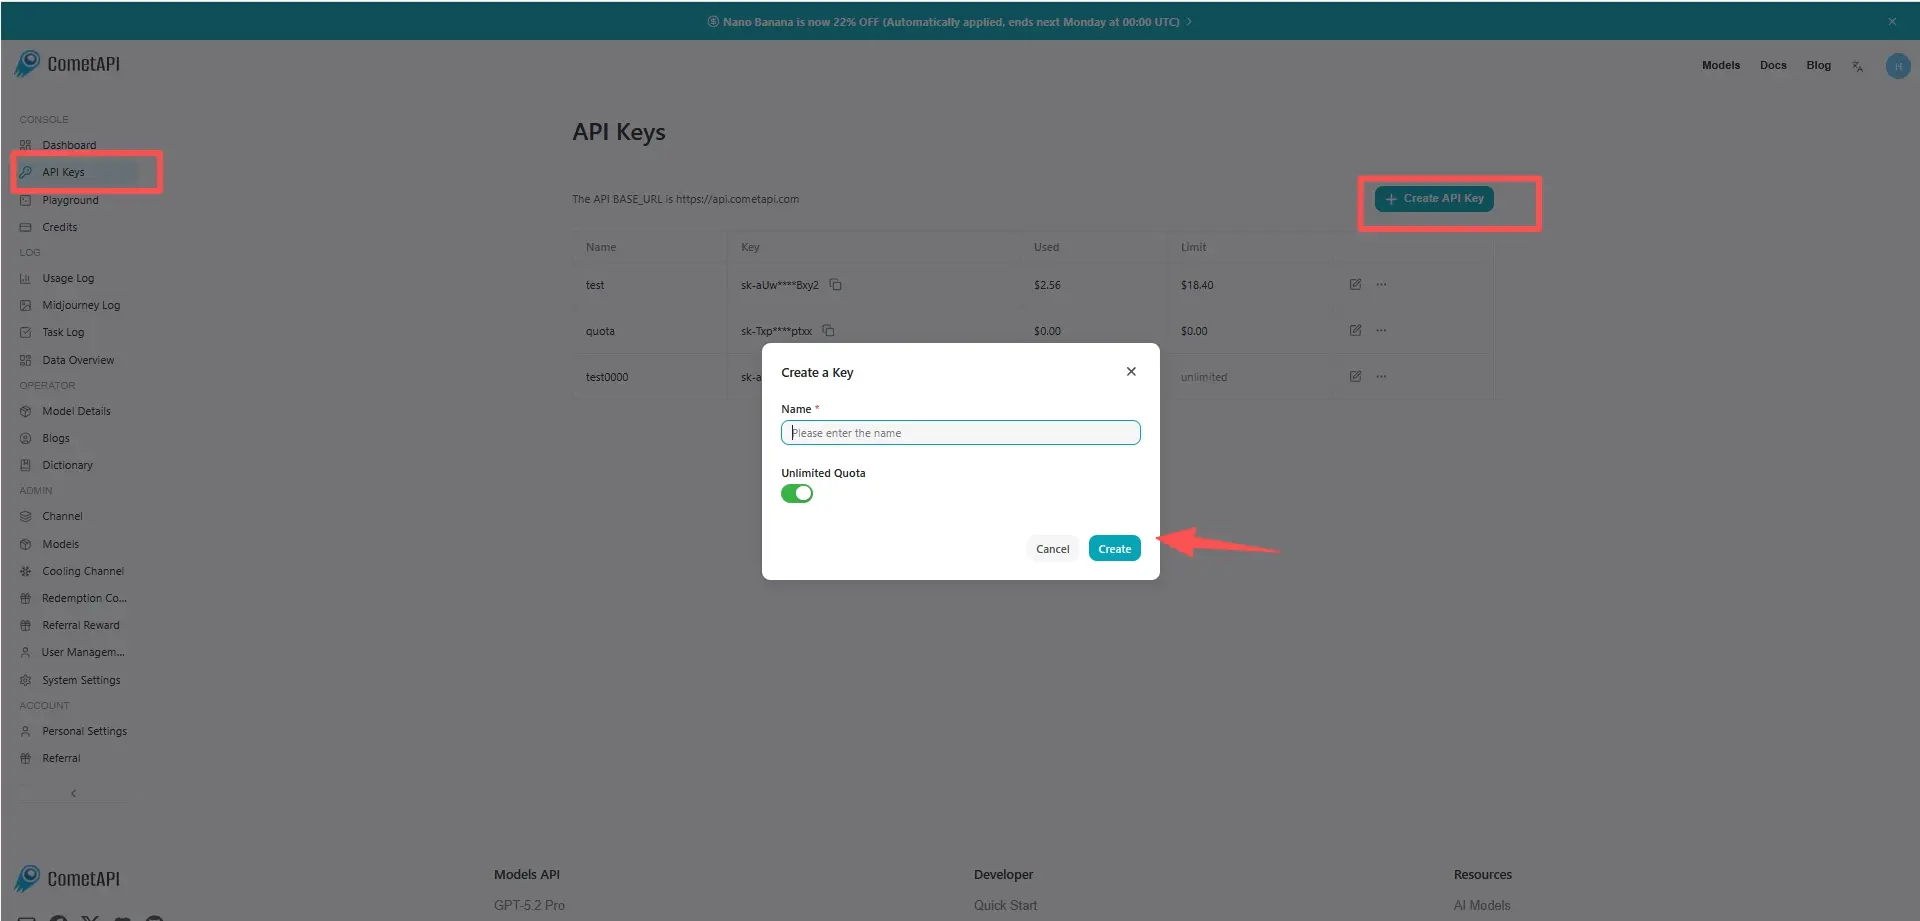
2단계: Gemini 3.6 Flash API로 요청 보내기
“ gemini-3.6-flash" "gemini-3.6-flash-thinking” 엔드포인트를 선택하여 API 요청을 보내고 요청 본문을 설정하세요. 요청 메서드와 요청 본문은 당사 웹사이트의 API 문서에서 확인할 수 있습니다. 편의를 위해 Apifox 테스트도 제공합니다. 계정의 실제 CometAPI 키로 <YOUR_API_KEY>를 교체하세요. base url is Gemini Generating Content
질문이나 요청을 content 필드에 삽입하세요—모델은 여기에 응답합니다 . API 응답을 처리하여 생성된 답변을 가져오세요.
3단계: 응답 처리
API는 생성된 텍스트, 인용, 안전성 메타데이터 및 선택적 도구 출력 등을 포함한 구조화된 후보 응답을 반환합니다.