

Mistral 3 to kluczowe wydanie rodziny modeli Mistral AI z końca 2025 roku. Przynosi mieszankę kompaktowych, szybkich modeli ukierunkowanych na wdrożenia lokalne/edge oraz bardzo duży, rzadki flagowiec, który przesuwa granice najnowocześniejszej skali i długości kontekstu. Ten artykuł wyjaśnia, czym jest Mistral 3, jak jest zbudowany, dlaczego warto uruchamiać go lokalnie oraz trzy praktyczne sposoby uruchomienia na Twojej maszynie lub prywatnym serwerze — od wygody „click-to-run” w Ollama, przez produkcyjne serwowanie GPU z vLLM/TGI, po inferencję na małych urządzeniach CPU z użyciem GGUF + llama.cpp.
Czym jest Mistral 3?
Mistral 3 to najnowsza generacja modeli o otwartych wagach od Mistral AI. Rodzina obejmuje zarówno masywny Mistral Large 3 (rzadki model Mixture-of-Experts — MoE), jak i kilka wariantów edge/„ministral” (3B, 8B, 14B) dostrojonych do podążania za instrukcjami oraz zadań multimodalnych (tekst+wizja). Mistral pozycjonuje wydanie jako szeroko użyteczne: od wydajnej inferencji w centrach danych (ze specjalnie zoptymalizowanymi punktami kontrolnymi) po zastosowania edge i na laptopach dzięki skwantyzowanym formatom i mniejszym wariantom.
Kluczowe właściwości praktyczne:
- Architektura Mixture-of-Experts (MoE) w wariancie Large 3, która zapewnia bardzo dużą „łączną” liczbę parametrów, przy aktywowaniu jedynie podzbioru ekspertów na token — poprawia to efektywność w skali.
- Rodzina modeli Ministral 3 (3B / 8B / 14B) przeznaczonych do użycia na brzegu i lokalnie, z wariantami dostrojonymi do instrukcji oraz multimodalnymi.
- Oficjalne punkty kontrolne i zestaw zoptymalizowanych punktów kontrolnych (NVFP4/FP8) dla przyspieszonych środowisk uruchomieniowych, takich jak vLLM i platformy NVIDIA.
- Multimodalność + wielojęzyczność + długi kontekst — warianty Ministral i Large kładą nacisk na rozumienie obrazu+tekstu oraz szerokie pokrycie językowe. W aplikacjach mieszających obrazy + długie dokumenty ma to znaczenie.
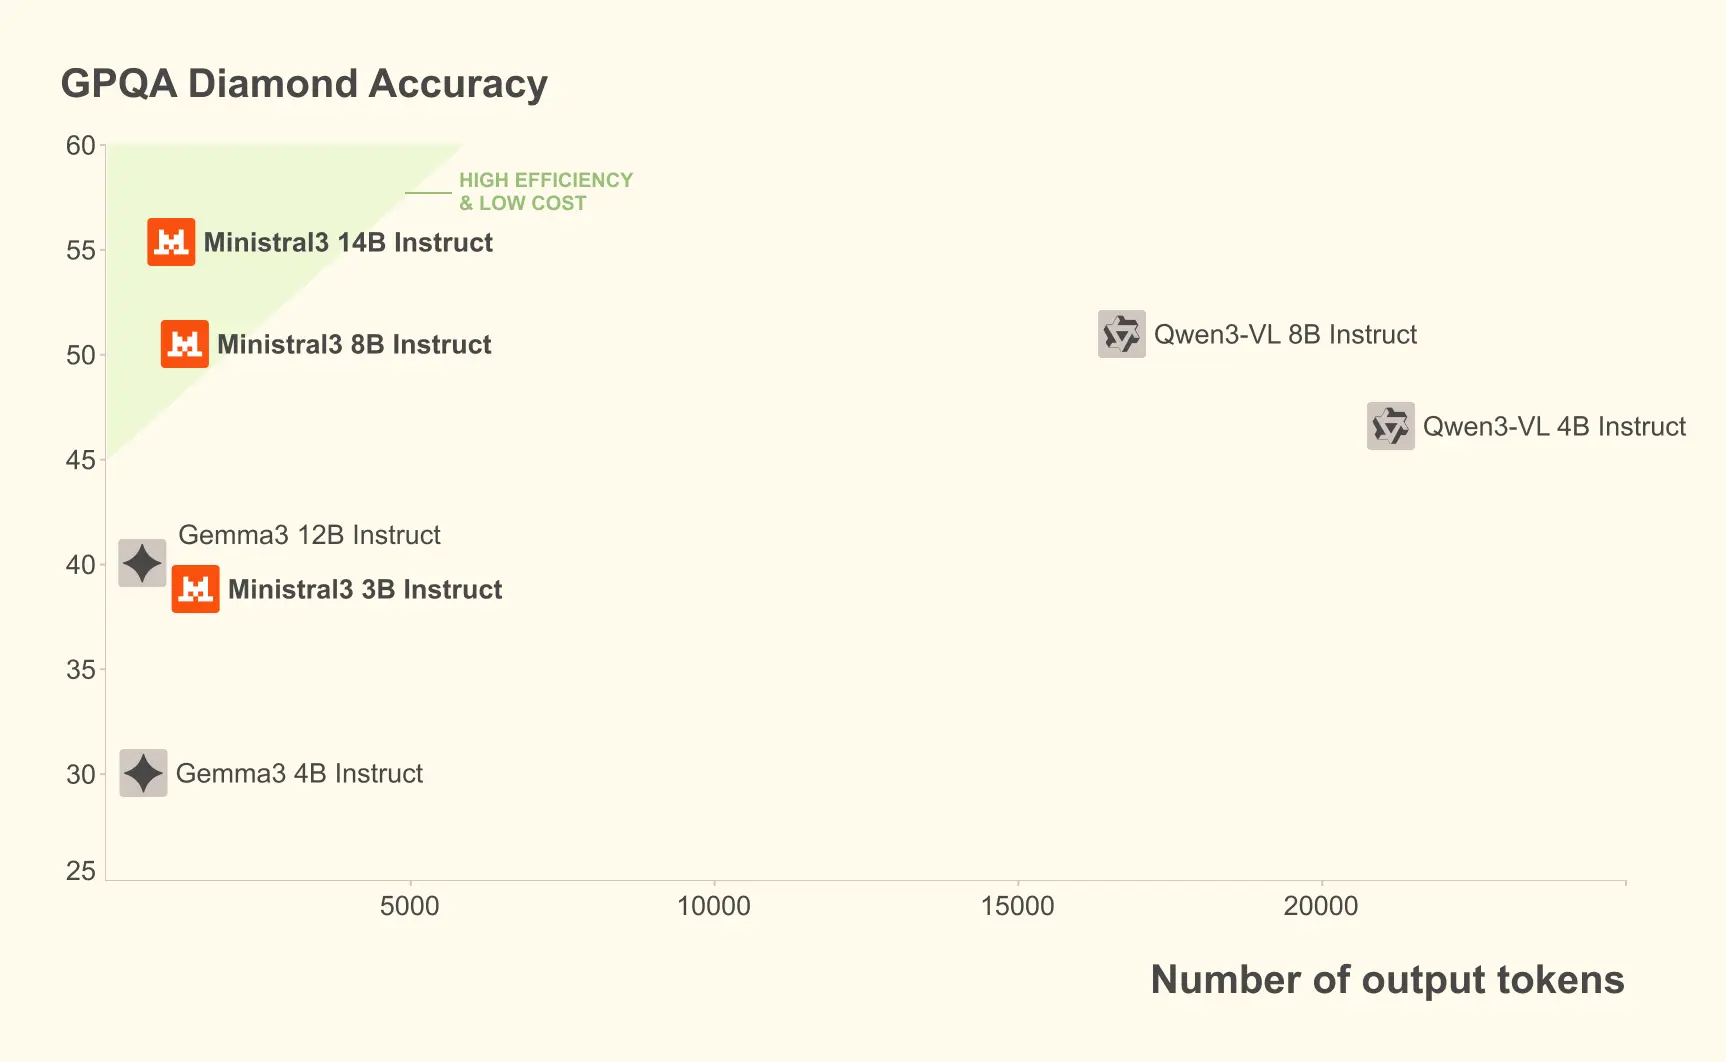
Na zbiorze GPQA Diamond (rigorystyczny test wnioskowania naukowego), różne warianty Ministral 3 utrzymują wysoką dokładność nawet przy rosnącej liczbie tokenów wyjściowych. Na przykład model Ministral 3B Instruct utrzymuje 35–40% dokładności przy obsłudze do 20 000 tokenów, porównywalnie do większych modeli jak Gemma 2 9B, zużywając mniej zasobów.
Jaka jest architektura Mistral 3?
Mistral 3 to rodzina, a nie pojedyncza architektura, ale dwa wzorce architektoniczne, które warto zrozumieć, to:
Gęste małe modele (Ministral 3)
- Standardowe stosy transformatorowe, zoptymalizowane pod kątem wydajności i inferencji na brzegu.
- Oferowane w wielu rozmiarach (3B/8B/14B) oraz w różnych wariantach po fine-tuningu: base, instruct i reasoning; wiele wariantów zawiera natywne wsparcie multimodalne (wizja + tekst) i pracę z długim kontekstem. Modele Ministral są wydawane z zoptymalizowanymi wagami FP8 dla kompaktowości w niektórych dystrybucjach.
Rzadka Mixture-of-Experts (Mistral Large 3)
- Architektura MoE: model ma wielu ekspertów (ogromna łączna liczba parametrów), ale na token oceniany jest jedynie podzbiór wybrany przez mechanizm routingu — zapewnia to lepszy kompromis skala/obliczenia.
- Mistral Large 3 podaje ~675B łącznych parametrów przy ~41B parametrów aktywnych podczas inferencji, co odzwierciedla projekt MoE. Model został wytrenowany na nowoczesnym sprzęcie NVIDIA i zoptymalizowany pod kątem efektywnego wykonania w niskiej precyzji (NVFP4/TensorRT/optimizacje large-kernel).
Funkcje techniczne istotne przy lokalnym uruchamianiu:
- Długi kontekst: niektóre warianty Mistral 3 wspierają bardzo długie konteksty (dokumentacja vLLM i Mistral wspomina o ogromnych oknach kontekstu dla niektórych wariantów; np. 256k w niektórych wariantach Ministral). Wpływa to na pamięć i wzorce serwowania.
- Formaty wag i kwantyzacja: Mistral udostępnia wagi w skompresowanych/zoptymalizowanych formatach (FP8, NVFP4) i współpracuje z nowoczesnymi narzędziami do kwantyzacji (BitsAndBytes, GPTQ, narzędzia dostawców) dla praktycznej lokalnej inferencji.
Dlaczego warto uruchamiać Mistral 3 lokalnie?
Lokalne uruchamianie LLM przestało być niszowym hobby — to praktyczna opcja dla zespołów i osób, którym zależy na:
- Prywatności danych i zgodności. Lokalne hostowanie zatrzymuje wrażliwe dane w Twojej infrastrukturze (istotne w finansach, opiece zdrowotnej, prawie). Reuters informował o klientach wysokiego szczebla wybierających samodzielne hostowanie modeli Mistral.
- Kontroli opóźnień i kosztów. Dla ciasnych SLO dotyczących opóźnień i przewidywalnych kosztów, lokalna lub prywatna inferencja w klastrze może pokonać szok kosztów API w chmurze. Mniejsze warianty Ministral i skwantyzowane formaty sprawiają, że jest to praktyczne.
- Dostosowaniu i fine-tuningu. Gdy potrzebujesz niestandardowych zachowań, wywoływania funkcji lub nowych modalności, lokalna kontrola umożliwia niestandardowy fine-tuning i obsługę danych. Integracja z Hugging Face i vLLM sprawia, że jest to bardziej „turnkey”.
Jeśli te powody są zgodne z Twoimi priorytetami — prywatność, kontrola, przewidywalne koszty lub badania — warto rozważyć wdrożenie lokalne.
Jak uruchomić Mistral 3 lokalnie (trzy praktyczne metody)?
Istnieje wiele sposobów uruchomienia Mistral 3 lokalnie. Omówię trzy podejścia, które pokrywają najczęstsze scenariusze użytkowników:
- Ollama (desktop/serwer lokalny bez konfiguracji, najłatwiejsze dla wielu użytkowników)
- Hugging Face Transformers + PyTorch / vLLM (pełna kontrola, klastry GPU)
- llama.cpp / ggml / GGUF skwantyzowana inferencja na CPU (lekka, działa na laptopach/CPU)
Dla każdej metody podam kiedy ma sens, wymagania wstępne, kroki i małe przykłady kodu.
1) Jak uruchomić Mistral 3 z Ollama (najszybsza ścieżka)?
Kiedy użyć: chcesz bezproblemowego doświadczenia lokalnego (macOS/Linux/Windows), przystępnego CLI lub GUI oraz automatycznych pobrań/skwantyzowanych artefaktów, gdy są dostępne. Ollama ma wpisy modeli dla Ministral 3 i innych członków rodziny Mistral.
Wymagania wstępne
- Zainstalowana Ollama (postępuj zgodnie z instalatorem na ollama.com). Biblioteka Ollama wskazuje konkretne minimalne wersje dla niektórych wydań Ministral.
- Wystarczająca ilość miejsca na dysku na artefakty modelu (rozmiary modeli się różnią — skwantyzowane wersje Ministral 3B mogą zajmować kilka GB; większe warianty BF16 to wiele dziesiątek GB).
Kroki (przykład)
- Zainstaluj Ollama (przykład dla macOS — zamień w zależności od platformy):
# macOS (Homebrew) example — see ollama.com for platform-specific installersbrew install ollama
- Uruchom model Ministral:
# Pull and run the model interactivelyollama run ministral-3
- Serwuj lokalnie (API) i wywołuj z kodu:
# Run Ollama server (default port shown in docs)ollama serve# Then curl against it (example)curl -s -X POST "http://localhost:11434/api/v1/generate" \ -H "Content-Type: application/json" \ -d '{"model":"ministral-3","prompt":"Summarize Mistral 3 in one sentence."}'
Uwagi i wskazówki
- Ollama obsługuje pobieranie modeli i (gdy dostępne) lokalne skwantyzowane warianty — bardzo wygodne do szybkiego próbowania modeli.
- Jeśli planujesz używać modelu w produkcji z wieloma równoczesnymi żądaniami, Ollama świetnie nadaje się do prototypowania, ale oceń skalowanie i orkiestrację zasobów dla stałego obciążenia.
2) Jak uruchomić Mistral 3 z Hugging Face Transformers (GPU / integracja z vLLM)?
Kiedy użyć: potrzebujesz programowej kontroli do badań lub produkcji, chcesz fine-tuning albo używać przyspieszonych stosów inferencji jak vLLM na klastrach GPU. Hugging Face zapewnia wsparcie Transformers, a Mistral oferuje zoptymalizowane punkty kontrolne dla vLLM/NVIDIA.
Wymagania wstępne
- GPU z odpowiednią pamięcią (zależnie od modelu i precyzji). Małe Ministral 3 (3B/8B) mogą działać na pojedynczym średniej klasy GPU po kwantyzacji; większe warianty wymagają wielu H100/A100 lub zoptymalizowanych punktów kontrolnych NVFP4 dla vLLM. Dokumentacja NVIDIA i Mistral rekomenduje konkretne rozmiary węzłów dla dużych modeli.
- Python, PyTorch, transformers, accelerate (lub vLLM, jeśli chcesz ten serwer).
Przykład w Pythonie — podstawowy pipeline Hugging Face (wariant 3B instruct, GPU):
# Example: CPU/GPU inference with transformers pipeline# Assumes you have CUDA and a compatible PyTorch build.import torchfrom transformers import pipelinemodel_name = "mistralai/Ministral-3-3B-Instruct-2512-BF16" # example HF model idgenerator = pipeline( "text-generation", model=model_name, device_map="auto", torch_dtype=torch.bfloat16, # use bfloat16 if your hardware supports it)prompt = "Explain how attention helps transformers, in 3 sentences."out = generator(prompt, max_new_tokens=120, do_sample=False)print(out[0]["generated_text"])
Użycie vLLM do produkcyjnej inferencji na GPU
vLLM jest zaprojektowany do efektywnego serwowania dużych modeli, wspiera rodzinę Mistral 3, a Mistral opublikował punkty kontrolne zoptymalizowane dla vLLM/sprzętu NVIDIA (NVFP4/FP8), aby zmniejszyć zużycie pamięci i przyspieszyć działanie. Uruchomienie serwera vLLM daje niskolatencyjny, zbatchowany punkt końcowy inferencji. Zobacz przepisy vLLM i wskazówki Mistral dotyczące ścieżek modeli oraz rekomendowanych flag.
Uwagi i wskazówki
- Do produkcji preferuj zoptymalizowane punkty kontrolne (NVFP4/FP8) i uruchamiaj na rekomendowanych GPU (np. H100/A100) lub użyj warstwy orkiestracji wspierającej równoległość tensora/modelu. Mistral i NVIDIA publikują dokumentację i wpisy blogowe o zoptymalizowanych środowiskach uruchomieniowych.
- Zawsze przypnij dokładny punkt kontrolny modelu na dysku (lub powtarzalny snapshot HF), aby zapewnić powtarzalne wyniki i uniknąć cichych aktualizacji modelu.
3) Jak uruchomić Mistral 3 na CPU za pomocą llama.cpp / skwantyzowanych modeli GGUF?
Kiedy użyć: potrzebujesz lokalnej, offline’owej inferencji na CPU (np. laptop deweloperski, bezpieczne środowisko odcięte od sieci) i akceptujesz pewną utratę jakości w zamian za szybkość i efektywność pamięciową. Ta metoda używa ggml/llama.cpp i skwantyzowanych wag GGUF (q4/q5/itd.).
Wymagania wstępne
- Skwantyzowana kompilacja GGUF modelu Ministral (wielu członków społeczności publikuje skwantyzowane GGUF na Hugging Face lub konwertuje wagi BF16 do GGUF lokalnie). Wyszukaj warianty GGUF
Ministral-3-3B-Instruct. - Skompilowany binarny plik llama.cpp (postępuj zgodnie z README projektu).
Kwantyzacja (jeśli masz oryginalne wagi) — przykład (koncepcyjnie)
# Example: quantize from an FP16/BF16 model to a GGUF q4_K_M (syntax depends on llama.cpp version)./quantize /path/to/original/model.bin /path/to/out.gguf q4_k_m
Uruchamianie GGUF z llama.cpp
# run interactive inference with a quantized GGUF model./main -m /path/to/ministral-3-3b-instruct.gguf -t 8 -c 2048 --interactive# -t sets threads, -c sets context (tokens) if supported
Przykład klienta w Pythonie (lokalny serwer llama.cpp lub proces potomny)
Możesz uruchomić llama.cpp jako proces potomny i podawać mu prompty albo użyć małego klienta-wrappera. Wiele projektów społeczności oferuje prostą nakładkę serwera HTTP na llama.cpp do integracji z lokalnymi aplikacjami.
Uwagi i kompromisy
- Kwantyzacja zmniejsza zużycie VRAM i umożliwia inferencję na CPU, ale może obniżyć jakość (łagodnie do umiarkowanie, zależnie od formatu kwantyzacji). Formatami często wybieranymi dla CPU są q4_K_M lub warianty q5 — to częste kompromisy. Japońskie i techniczne wpisy szczegółowo opisują typy Q4/Q5 i konwersje do GGUF.
- Dla małych i średnich obciążeń GGUF + llama.cpp często są najtańszym i najbardziej przenośnym sposobem uruchamiania lokalnych LLM.
Jakie kwestie sprzętowe i pamięciowe mają znaczenie?
Krótka, praktyczna wskazówka:
- Modele 3B: często można skwantyzować i uruchamiać na przyzwoitym CPU w laptopie lub na pojedynczym GPU z 8–16 GB VRAM (zależnie od precyzji/kwantyzacji). Warianty GGUF q4 działają na wielu nowoczesnych CPU.
- Ministral 8B i 14B: zwykle wymagają GPU średniej klasy (np. 24–80 GB zależnie od precyzji i cache’u aktywacji) lub kwantyzacji na wielu urządzeniach.
- Mistral Large 3 (675B łącznie, 41B aktywnych): przeznaczony do wdrożeń w centrach danych i zwykle najlepiej działa na węzłach z wieloma GPU (np. 8×A100 lub H100) oraz w specjalistycznych formatach (NVFP4/FP8) dla vLLM. Mistral wyraźnie opublikował zoptymalizowane punkty kontrolne, aby takie wdrożenia były wykonalne.
Jeśli Twoim priorytetem jest użycie na laptopie, celuj w ścieżkę Ministral 3B skwantyzowany GGUF + llama.cpp. Jeśli priorytetem jest produkcyjna przepustowość, rozważ vLLM + punkty kontrolne NVFP4 na GPU. Jeśli chcesz łatwo eksperymentować, Ollama jest najszybszym startem.
Jak dobrać kwantyzację i precyzję?
Kwantyzacja to kompromis: pamięć i szybkość vs. „surowa” jakość modelu. Popularne wybory:
- q4_0 / q4_1 / q4_K_M: popularne opcje 4-bitowe używane w inferencji na CPU; q4_K_M (wariant k-średnich) często oferuje lepszy balans jakości/wydajności.
- warianty q5 / q8 / imatrix: formaty pośrednie, które mogą zachować więcej wierności kosztem rozmiaru.
- FP16 / BF16 / FP8 / NVFP4: precyzje GPU — BF16 i FP16 są powszechne w treningu/inferencji na nowoczesnych GPU; FP8 / NVFP4 to nowe formaty oszczędzające pamięć, wspierane przez zoptymalizowane środowiska uruchomieniowe i wydania punktów kontrolnych Mistral.
Ogólna zasada: do lokalnych uruchomień na CPU wybierz q4_K_M lub podobny; do inferencji na GPU z wysoką wiernością używaj BF16/FP16 lub wspieranych przez runtime formatów FP8/NVFP4.
Wnioski — czy warto uruchamiać Mistral 3 lokalnie?
Jeśli potrzebujesz prywatności, niskich opóźnień lub dostosowania, tak: rodzina Mistral 3 daje szeroką paletę — małe modele dla edge/CPU, średnie modele dla pojedynczego GPU lub skromnego klastra oraz duży wariant MoE dla skali centrum danych — a ekosystem (Ollama, Hugging Face, vLLM, llama.cpp) już wspiera praktyczne wzorce wdrożeń lokalnych i prywatnych. Mistral współpracował także z NVIDIA i vLLM nad zoptymalizowanymi punktami kontrolnymi dla wysokiej przepustowości i mniejszego zużycia pamięci, co sprawia, że produkcyjne samodzielne hostowanie jest bardziej realistyczne niż wcześniej.
Aby zacząć, poznaj możliwości innych modeli (np. [Gemini 3 Pro]) w [Playground] i zapoznaj się z [API guide] po szczegółowe instrukcje. Przed dostępem upewnij się, że zalogowałeś się do CometAPI i uzyskałeś klucz API. [CometAPI] oferuje cenę znacznie niższą niż oficjalna, aby pomóc Ci w integracji.
Gotowy do działania?→ [Sign up for CometAPI today] !