Specyfikacja techniczna GLM-5.2
| Parametr | GLM-5.2 |
|---|---|
| Dostawca | Zhipu AI |
| Data wydania | June 13, 2026 |
| Typ modelu | LLM typu Mixture-of-Experts (MoE) o otwartych wagach |
| Łączna liczba parametrów | ~744B |
| Aktywne parametry | ~40B na token |
| Okno kontekstu | 1,000,000 tokenów |
| Maksymalna długość wyjścia | 131,072 tokenów |
| Tryby rozumowania | High, Max |
| Licencja | MIT |
| Główne zastosowania | Programowanie agentowe, inżynieria oprogramowania, długoterminowe rozumowanie |
| Dostępność API | Platforma Z.ai i kompatybilni dostawcy |
| Otwarte wagi | Tak |
GLM-5.2 to najnowszy flagowy model z rodziny GLM firmy Zhipu AI. W odróżnieniu od uniwersalnych modeli z najwyższej półki, GLM-5.2 jest pozycjonowany przede wszystkim jako model “coding-first” i zorientowany na agentów, zaprojektowany do inżynierii oprogramowania w skali repozytoriów, autonomicznych przepływów pracy oraz rozumowania na ekstremalnie długich kontekstach. Jego flagową możliwością jest natywne okno kontekstu o wielkości 1 miliona tokenów, co czyni go jednym z największych publicznie dostępnych wśród modeli o otwartych wagach.
Główne funkcje GLM-5.2
- Okno kontekstu 1M tokenów dla całych repozytoriów, obszernych zbiorów dokumentacji i wielosesyjnych przepływów pracy agentów.
- Optymalizacja zorientowana na kodowanie, ukierunkowana na refaktoryzację, debugowanie, generowanie kodu i zadania z zakresu inżynierii oprogramowania.
- Obsługa agentowych przepływów pracy dla narzędzi takich jak Claude Code, Cline, Roo Code, OpenCode i podobne agenty do kodowania.
- Wydanie z otwartymi wagami na licencji MIT, umożliwiające samodzielne hostowanie i fine-tuning.
- Dwa tryby rozumowania (High i Max) pozwalające równoważyć opóźnienie i głębokość rozumowania.
- Duża architektura MoE z około 744B łącznych parametrów, przy aktywacji jedynie ~40B na token dla wydajności.
Wydajność w benchmarkach GLM-5.2
Zhipu nie opublikowało kompleksowych oficjalnych wyników benchmarków na starcie, co sprawia, że bezpośrednie porównania są bardziej niepewne niż w przypadku modeli takich jak GPT-5 czy Claude. Wiele branżowych raportów odnotowuje brak niezależnie zweryfikowanych publikacji wyników benchmarków.
| Benchmark | Zgłaszany wynik |
|---|---|
| Terminal-Bench 2.1 | 81.0 |
| SWE-Bench Pro | 62.1 |
| NL2Repo | 48.9 |
| AIME 2026 | 99.2 |
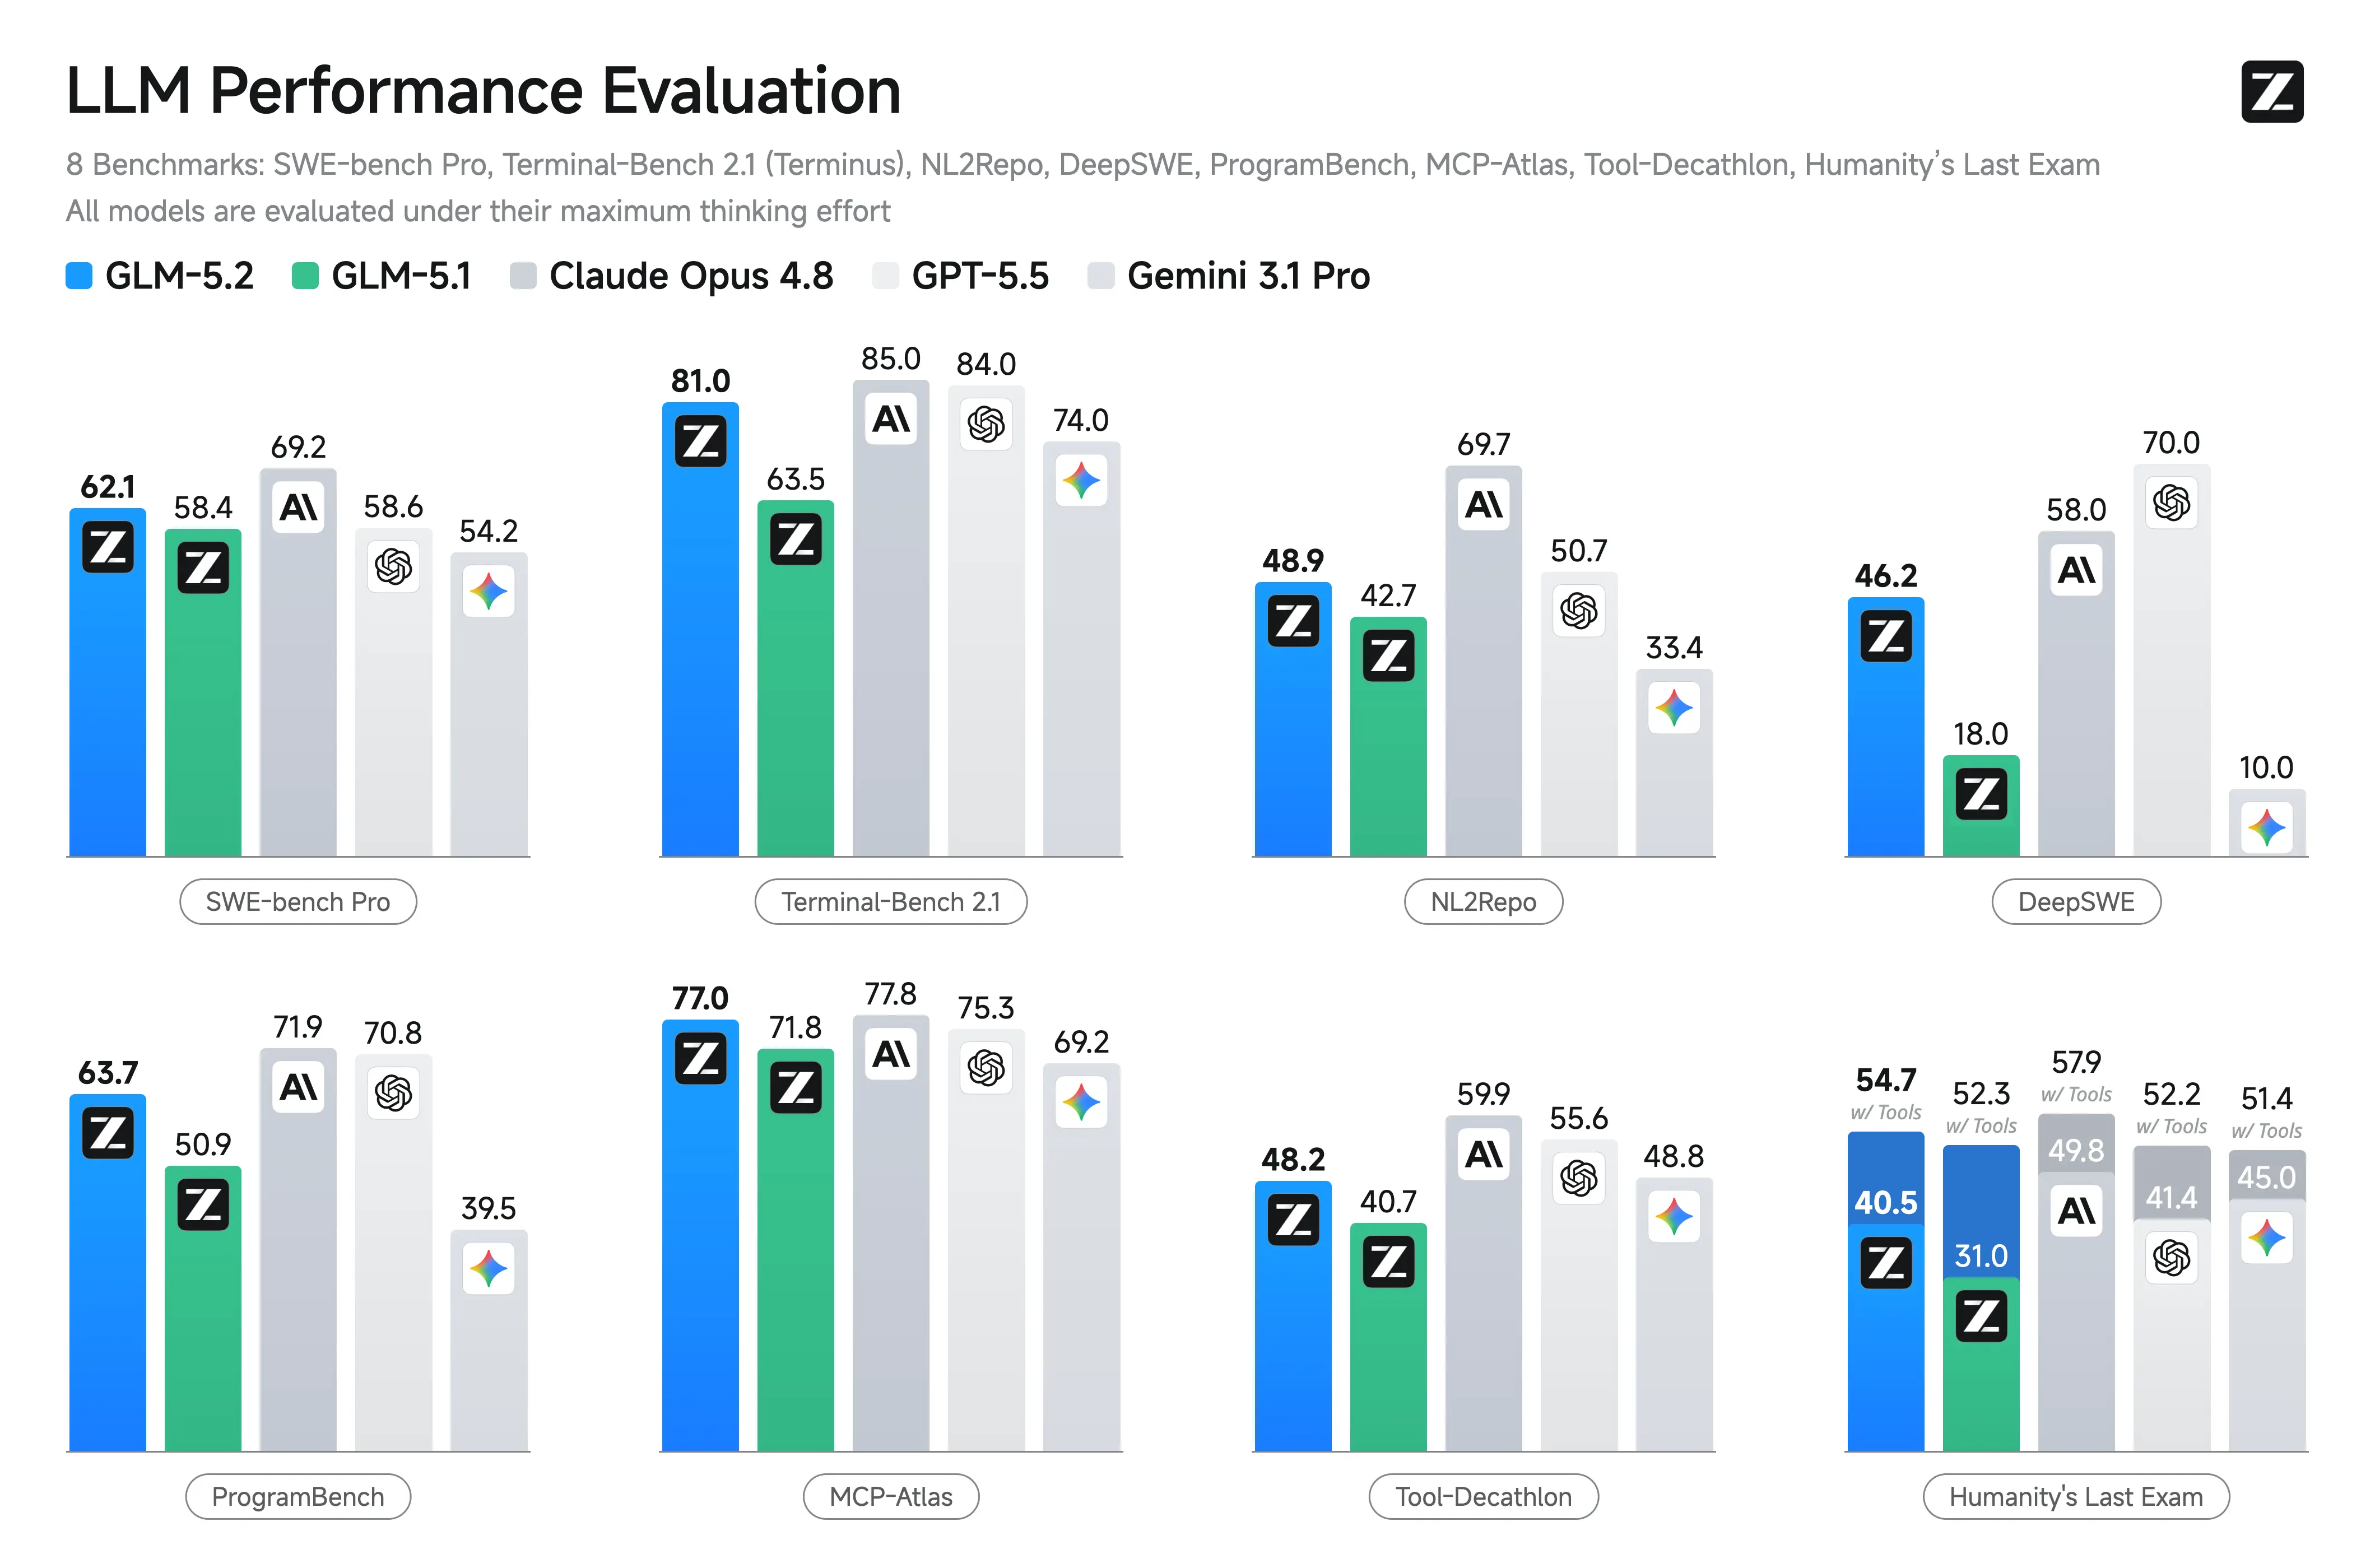
GLM-5.2 vs GLM-5.1 vs Claude Opus 4.8
| Specyfikacja | GLM-5.2 | GLM-5.1 | Claude Opus 4.8 |
|---|---|---|---|
| Data wydania | 2026-06-13 | 2026 | 2026 |
| Okno kontekstu | 1,000,000 | ~200,000 | 1,000,000 |
| Otwarte wagi | Yes (MIT) | Yes | No |
| Tryby rozumowania | High, Max | Standard | Extended Thinking |
| Łączna liczba parametrów | 744B | 744B | Not disclosed |
| Aktywne parametry | 40B | 40B | Not disclosed |
| Oficjalne dane benchmarkowe | Not published | Published at launch | Published |
Główną udokumentowaną zmianą w GLM-5.2 względem GLM-5.1 jest rozszerzenie okna kontekstu do 1M tokenów oraz wprowadzenie wybieralnych trybów rozumowania High i Max. Na starcie Z.ai nie opublikowało oficjalnych wyników SWE-Bench, LiveCodeBench, HumanEval ani podobnych benchmarków, więc porównania wydajności z Claude Opus 4.8, GPT-5, DeepSeek czy Qwen pozostają niezweryfikowane.
W porównaniu z innymi otwartymi modelami, głównym wyróżnikiem GLM-5.2 jest połączenie bardzo dużego okna kontekstu, specjalizacji w kodowaniu i licencji MIT. Najsilniejszy atut to inżynieria oprogramowania w skali repozytoriów, a nie ogólne aplikacje czatowe.
Dlaczego warto używać GLM-5.2 przez CometAPI?
CometAPI umożliwia deweloperom integrację GLM-5.2 przez ten sam interfejs, który jest używany dla dziesiątek wiodących modeli AI.
Korzyści obejmują:
- Ujednolicone uwierzytelnianie u wielu dostawców
- Integracja API kompatybilna z OpenAI
- Uproszczone rozliczenia i zarządzanie wykorzystaniem
- Szybkie eksperymentowanie z alternatywnymi modelami
- Łatwe przełączanie między modelami do kodowania, rozumowania, obrazu, dźwięku i wideo
- Mniejsze uzależnienie od dostawców (vendor lock-in) w systemach produkcyjnych
Niezależnie od tego, czy tworzysz IDE z AI, wewnętrznego asystenta inżynieryjnego czy platformę automatyzacji dla przedsiębiorstw, CometAPI minimalizuje nakład pracy integracyjnej, zachowując elastyczność.
Jak uzyskać dostęp do API GLM-5.2 w CometAPI
Zacznij korzystać z naszego produktu w kilku prostych krokach...
Krok 1: Zarejestruj się po klucz API GLM-5.2
Utwórz konto w CometAPI i przejdź do panelu API, aby wygenerować swój klucz API GLM-5.2. Ten klucz uwierzytelnia wszystkie Twoje żądania i daje natychmiastowy dostęp do pełnych możliwości API GLM-5.2, w tym do okna kontekstu 1M tokenów oraz 128k tokenów wyjściowych.
Krok 2: Wysyłaj żądania do API GLM-5.2
Użyj swojego klucza API GLM-5.2, aby wysyłać żądania POST do endpointu CometAPI. Przekaż swój prompt, ustaw parametry modelu, takie jak effort level i max tokens, a API GLM-5.2 przetworzy Twoje żądanie — od generowania kodu, przez analizę dokumentów, po agentowe użycie narzędzi.
Krok 3: Odbieraj wyniki i integruj API GLM-5.2
API GLM-5.2 zwraca ustrukturyzowane odpowiedzi, w tym tekst uzupełnienia, instrukcje wywoływania narzędzi oraz metadane użycia tokenów. Obsługuje zarówno standardowe odpowiedzi synchroniczne, jak i strumieniowanie w czasie rzeczywistym poprzez Server-Sent Events (SSE), gdy skonfigurowano stream: true. Endpoint można łatwo zintegrować z istniejącymi przepływami pracy przy użyciu standardowych klientów HTTP lub openAI compatible SDKs, kierując żądania przez url(//api.cometapi.com/v1) z użyciem swojego Bearer Token.