Especificações técnicas do Gemini 3.6 Flash
| Item | Gemini 3.6 Flash |
|---|---|
| Provedor | Google DeepMind |
| ID do modelo | gemini-3.6-flash |
| Família do modelo | Gemini 3.x |
| Disponibilidade | Disponibilidade geral (GA) |
| Tipos de entrada | Texto, imagem, vídeo, áudio, PDF |
| Tipos de saída | Texto |
| Janela de contexto | 1,048,576 tokens |
| Saída máxima | 65,536 tokens |
| Raciocínio | Suportado (médio / alto) |
| Chamada de função | Sim |
| Execução de código | Sim |
| Pesquisa de arquivos | Sim |
| Contexto de URL | Sim |
| Grounding de pesquisa | Sim |
| Uso de computador | Prévia |
| Saída estruturada | Sim |
| Cache | Suportado |
Fonte: Documentação da API do Google Gemini.
O que é o Gemini 3.6 Flash?
O Gemini 3.6 Flash é o mais novo modelo Flash pronto para produção do Google, projetado para oferecer inteligência de ponta mantendo a baixa latência e a eficiência de custo pelas quais a série Flash é conhecida. Ele é otimizado para programação, compreensão multimodal, raciocínio e fluxos de trabalho orientados a agentes.
Em comparação com o Gemini 3.5 Flash, o modelo melhora a qualidade de geração de código, a precisão de raciocínio, o uso de ferramentas e a eficiência de tokens, ao mesmo tempo em que oferece uma janela de contexto massiva de 1 milhão de tokens. O Google o posiciona como o modelo de trabalho padrão para desenvolvedores que constroem agentes de IA e sistemas de automação complexos.
Principais recursos do Gemini 3.6 Flash
- Suporta processamento de contexto longo de 1M tokens.
- Entradas multimodais nativas, incluindo texto, imagens, vídeo, áudio e documentos PDF.
- Grandes melhorias na geração de código e em tarefas de engenharia de software.
- Suporte integrado a Chamada de função, Pesquisa de arquivos, Contexto de URL, Grounding de pesquisa e Uso de computador.
- Mais eficiente em tokens do que o Gemini 3.5 Flash, reduzindo o custo de inferência enquanto mantém maior qualidade.
- Projetado para agentes de IA de múltiplas etapas e fluxos de trabalho autônomos.
Desempenho em benchmarks
O Google relata que o Gemini 3.6 Flash oferece desempenho superior em programação, raciocínio e multimodalidade em relação ao Gemini 3.5 Flash, usando significativamente menos tokens de saída. A empresa destaca desempenho aprimorado em benchmarks internos de programação e de agentes e afirma que o modelo pode reduzir o uso de tokens de saída em até 65% em certas avaliações de engenharia de software, como o DeepSWE, diminuindo o custo total de inferência. O Google não publicou tabelas de benchmarks públicas abrangentes (por exemplo, MMLU, GPQA, SWE-bench Verified) para esta versão.
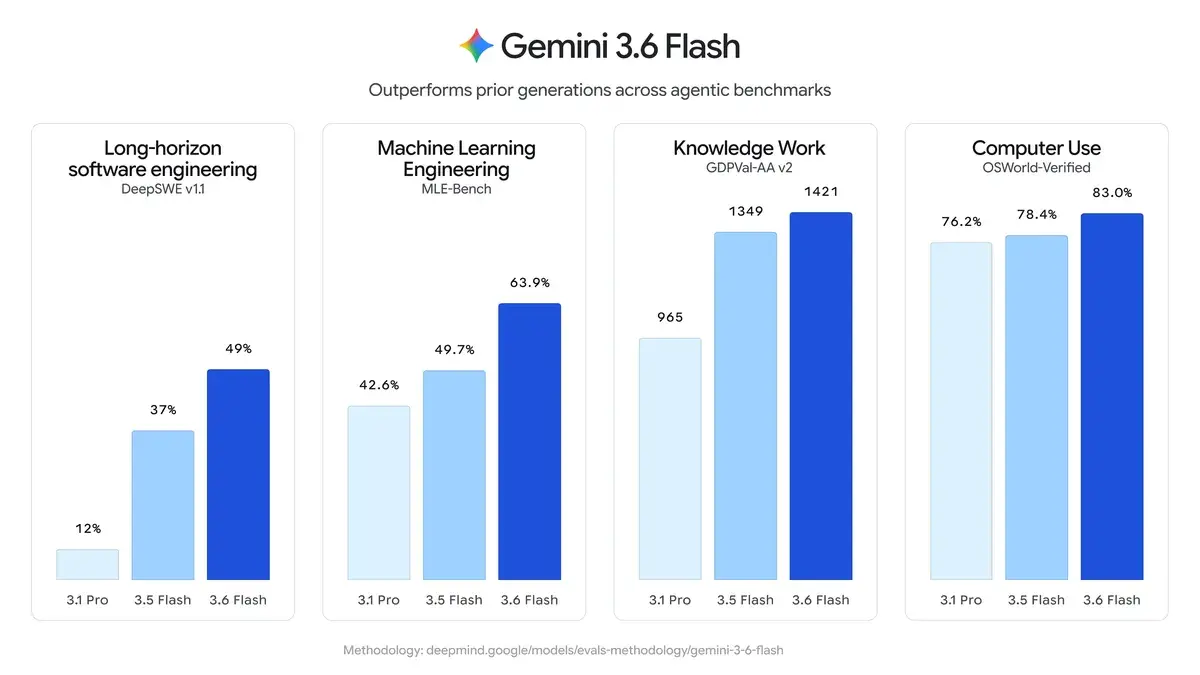
Gemini 3.6 Flash vs Gemini 3.5 Flash vs Gemini 3.1 Pro
| Aspecto | Gemini 3.6 Flash | Gemini 3.5 Flash | Gemini 3.1 Pro |
|---|---|---|---|
| Lançamento | 21 de julho de 2026 (GA) | Mais cedo em 2026 | ~fev. 2026 (Prévia) |
| Posicionamento | Cavalaria eficiente para agentes, programação, multimodal | Modelo Flash agentivo anterior | Raciocínio avançado nível Pro |
| Preços (por 1M de tokens) | Entrada: $1.50Saída: $7.50 | Entrada: $1.50Saída: $9.00 | Mais altos (ex.: ~$2 entrada / $12 saída) |
| Eficiência de tokens | 17% menos tokens de saída vs 3.5 Flash; menos etapas/chamadas de ferramentas | Referência | Menos eficiente em fluxos agentivos |
| Velocidade | Alta (família Flash) | Alta | Mais lenta que os modelos Flash |
| Janela de contexto | 1M tokens | 1M tokens | Provavelmente semelhante |
| Pontos fortes | Programação, trabalho de conhecimento, multimodal (gráficos/documentos), uso de computador, eficiência agentiva | Bom equilíbrio agentivo/programação | Raciocínio mais profundo em problemas complexos |
Resumo rápido
- 3.6 Flash → Melhor escolha geral para a maioria dos usuários no momento: mais rápido, mais barato por tarefa, mais eficiente que o 3.5 Flash e supera o 3.1 Pro em muitos benchmarks práticos/agentivos.
- 3.5 Flash → Predecessor sólido; ainda capaz, mas sendo substituído pelo 3.6 Flash (custo de tokens de saída mais alto, menos eficiente).
- 3.1 Pro → Mais forte em alguns cenários de raciocínio profundo, porém mais lento, mais caro e, em geral, fica atrás dos modelos Flash mais recentes em velocidade, eficiência e muitas tarefas do mundo real/agentivas.
Limitações
- Geração de imagens não é suportada diretamente.
- Geração de áudio não está disponível.
- Uso de computador permanece em Prévia.
- Alguns parâmetros legados de geração (
temperature,top_p,top_k) foram removidos da nova interface da API. - O melhor desempenho é obtido por meio da API Gemini Interactions mais recente.
Como acessar a API do Gemini 3.6 Flash
Etapa 1: Obtenha acesso à API
Faça login no cometAPI. Se você ainda não é nosso usuário, registre-se primeiro. Acesse seu CometAPI console. Obtenha a chave de API de credenciais de acesso da interface. Clique em “Add Token” no token de API no centro pessoal, obtenha a chave do token: sk-xxxxx e envie.
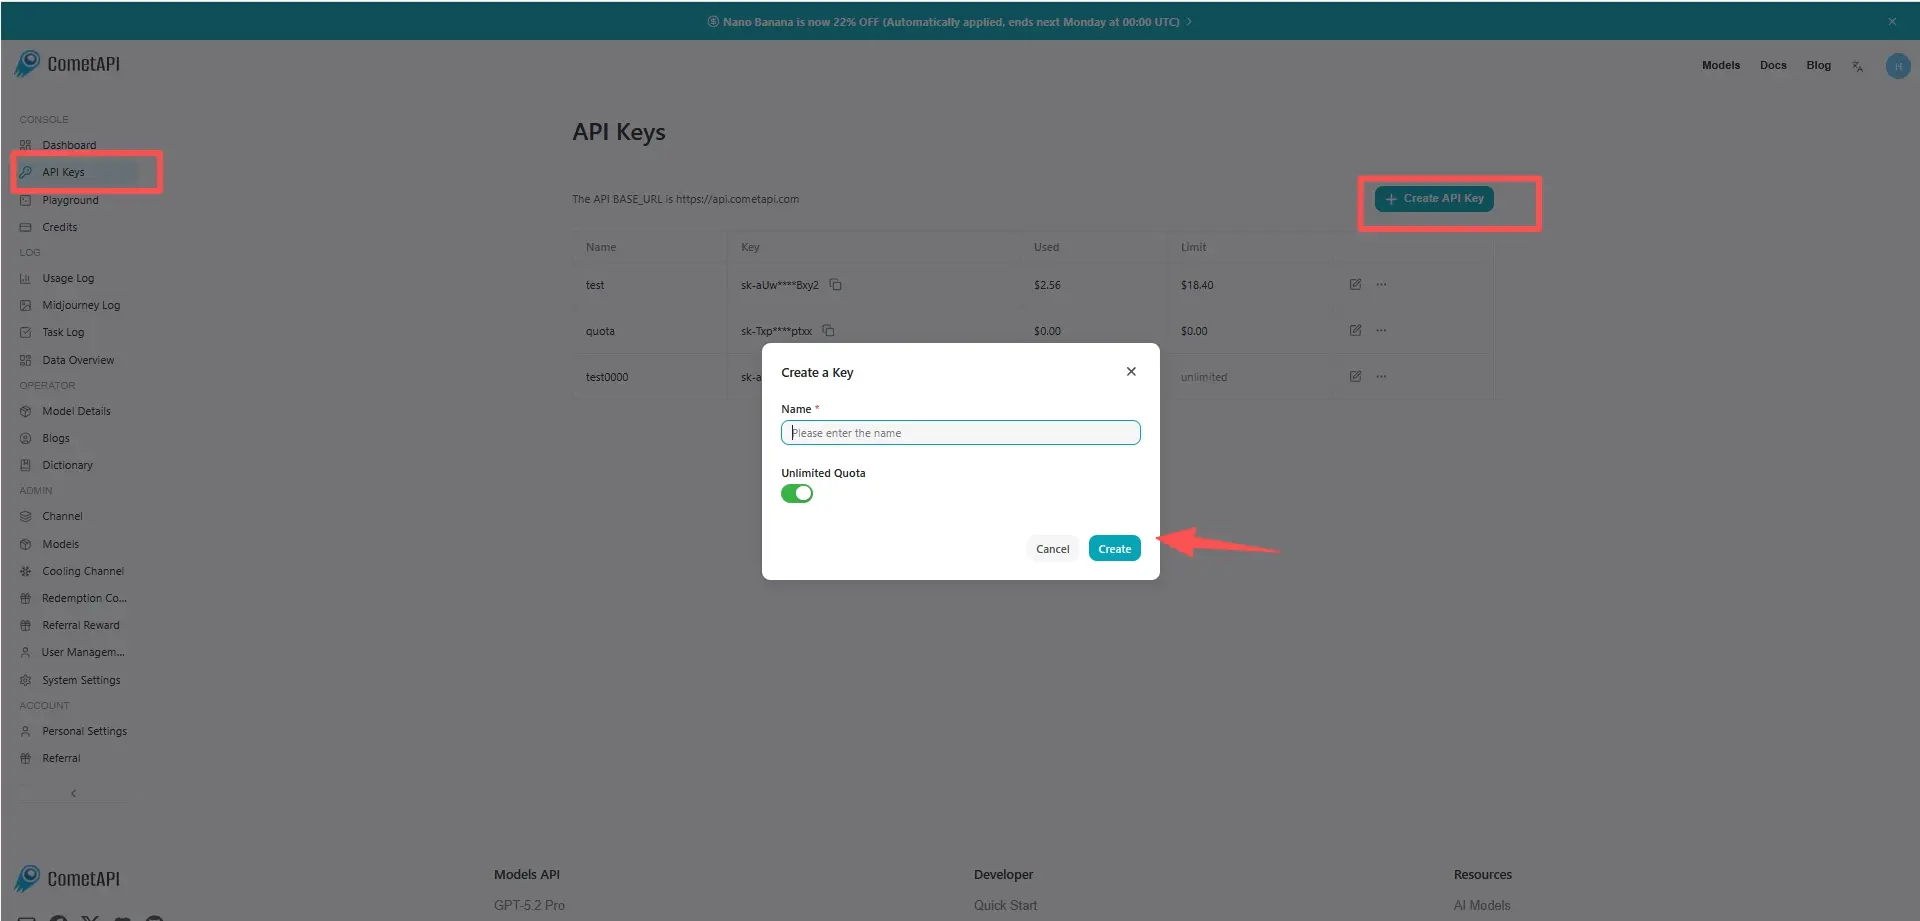
Etapa 2: Envie solicitações para a API do Gemini 3.6 Flash
Selecione o endpoint “ gemini-3.6-flash" "gemini-3.6-flash-thinking” para enviar a solicitação de API e defina o corpo da solicitação. O método e o corpo da solicitação são obtidos na documentação da API do nosso site. Nosso site também oferece teste no Apifox para sua conveniência. Substitua <YOUR_API_KEY> pela sua chave CometAPI do seu conta. o URL base é Geração de conteúdo do Gemini
Insira sua pergunta ou solicitação no campo content — é isso que o modelo irá responder. Procese a resposta da API para obter a resposta gerada.
Etapa 3: Processe as respostas
A API retorna respostas de candidatos estruturadas, incluindo texto gerado, citações, metadados de segurança e saídas opcionais de ferramentas.