Specyfikacja techniczna Gemini 3.6 Flash
| Parametr | Gemini 3.6 Flash |
|---|---|
| Dostawca | Google DeepMind |
| ID modelu | gemini-3.6-flash |
| Rodzina modelu | Gemini 3.x |
| Dostępność | Ogólna dostępność (GA) |
| Typy wejścia | Tekst, obraz, wideo, audio, PDF |
| Typy wyjścia | Tekst |
| Okno kontekstu | 1,048,576 tokenów |
| Maksymalne wyjście | 65,536 tokenów |
| Thinking | Obsługiwane (średni / wysoki) |
| Function calling | Tak |
| Code execution | Tak |
| File Search | Tak |
| URL Context | Tak |
| Search Grounding | Tak |
| Computer Use | Wersja zapoznawcza |
| Structured Output | Tak |
| Caching | Obsługiwane |
Źródło: dokumentacja Google Gemini API.
Czym jest Gemini 3.6 Flash?
Gemini 3.6 Flash to najnowszy, gotowy do produkcji model z serii Flash od Google, zaprojektowany, aby zapewniać inteligencję na poziomie czołówki, przy zachowaniu niskich opóźnień i efektywności kosztowej, z których słynie seria Flash. Został zoptymalizowany pod kątem programowania, multimodalnego rozumienia, wnioskowania i agentowych przepływów pracy.
W porównaniu z Gemini 3.5 Flash model poprawia jakość generowania kodu, dokładność wnioskowania, wykorzystanie narzędzi oraz efektywność tokenową, jednocześnie obsługując ogromne okno kontekstu rzędu 1 miliona tokenów. Google pozycjonuje go jako domyślny „koń pociągowy” dla deweloperów budujących agentów AI i złożone systemy automatyzacji.
Główne funkcje Gemini 3.6 Flash
- Obsługuje przetwarzanie długiego kontekstu do 1M tokenów.
- Natywne wejścia multimodalne, w tym tekst, obrazy, wideo, audio i dokumenty PDF.
- Znaczne ulepszenia w generowaniu kodu i zadaniach inżynierii oprogramowania.
- Wbudowana obsługa Function Calling, File Search, URL Context, Search Grounding i Computer Use.
- Bardziej efektywny pod względem tokenów niż Gemini 3.5 Flash, obniżając koszt inferencji przy zachowaniu wyższej jakości.
- Zaprojektowany z myślą o wieloetapowych agentach AI i autonomicznych przepływach pracy.
Wydajność w benchmarkach
Google informuje, że Gemini 3.6 Flash zapewnia lepszą wydajność w kodowaniu, wnioskowaniu i zadaniach multimodalnych niż Gemini 3.5 Flash, jednocześnie używając znacznie mniejszej liczby tokenów wyjściowych. Firma podkreśla poprawę wyników w wewnętrznych benchmarkach dotyczących kodowania i agentów oraz stwierdza, że model może zmniejszyć zużycie tokenów wyjściowych nawet o 65% w niektórych ewaluacjach inżynierii oprogramowania, takich jak DeepSWE, obniżając ogólne koszty inferencji. Google nie opublikowało kompleksowych, publicznych tabel benchmarków (np. MMLU, GPQA, SWE-bench Verified) dla tego wydania.
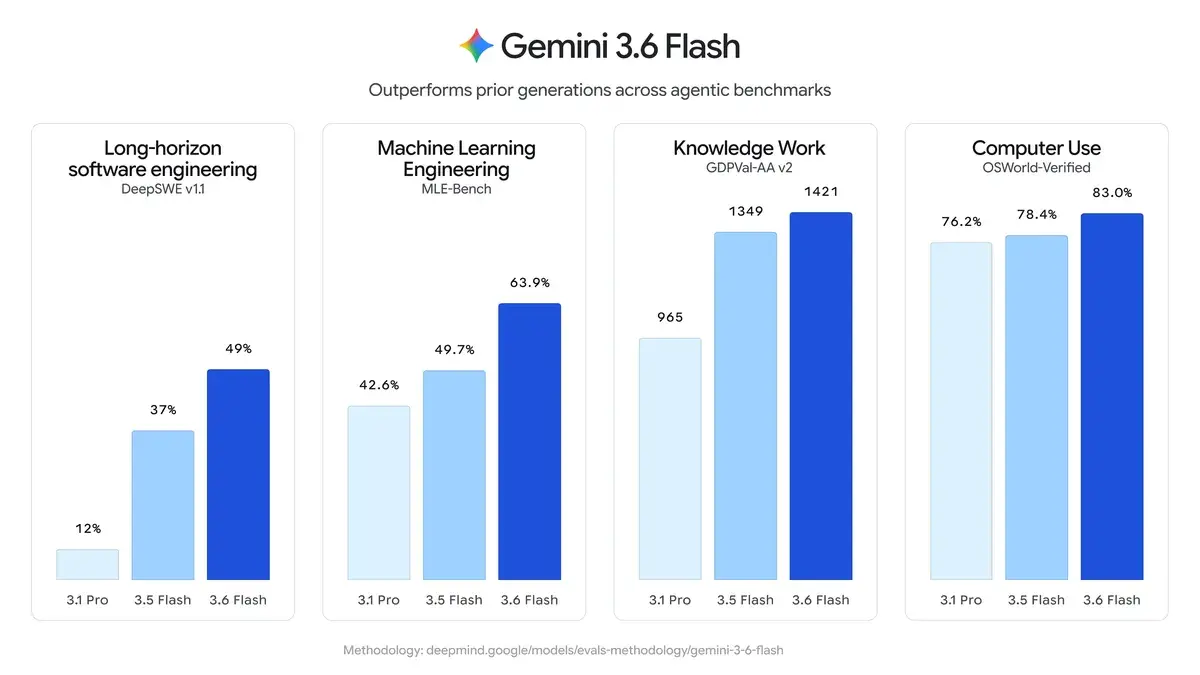
Gemini 3.6 Flash vs Gemini 3.5 Flash vs Gemini 3.1 Pro
| Aspekt | Gemini 3.6 Flash | Gemini 3.5 Flash | Gemini 3.1 Pro |
|---|---|---|---|
| Wydanie | 21 lipca 2026 (GA) | Wcześniej w 2026 r. | ~lut 2026 (wersja zapoznawcza) |
| Pozycjonowanie | Wydajny „koń pociągowy” dla agentów, programowania, multimodalności | Poprzedni agentowy model Flash | Zaawansowane wnioskowanie klasy Pro |
| Cennik (za 1M tokenów) | Wejście: $1.50Wyjście: $7.50 | Wejście: $1.50Wyjście: $9.00 | Wyższy (np. ~$2 wejście / $12 wyjście) |
| Efektywność tokenowa | o 17% mniej tokenów wyjściowych vs 3.5 Flash; mniej kroków/wywołań narzędzi | Punkt odniesienia | Mniej efektywny w przepływach agentowych |
| Szybkość | Wysoka (rodzina Flash) | Wysoka | Wolniejszy niż modele Flash |
| Okno kontekstu | 1M tokenów | 1M tokenów | Prawdopodobnie podobne |
| Mocne strony | Kodowanie, praca z wiedzą, multimodalność (wykresy/dokumenty), Computer Use, efektywność agentowa | Dobry balans agentów/kodowania | Głębsze wnioskowanie nad złożonymi problemami |
Szybkie podsumowanie
- 3.6 Flash → Najlepszy ogólny wybór dla większości użytkowników: szybszy, tańszy per zadanie, bardziej efektywny niż 3.5 Flash i przewyższa 3.1 Pro w wielu praktycznych/agentowych benchmarkach.
- 3.5 Flash → Solidny poprzednik; nadal kompetentny, ale wypierany przez 3.6 Flash (wyższy koszt tokenów wyjściowych, mniejsza efektywność).
- 3.1 Pro → Silniejszy w niektórych scenariuszach głębokiego wnioskowania, ale wolniejszy, droższy i generalnie ustępujący nowszym modelom Flash pod względem szybkości, efektywności i wielu zadań praktycznych/agentowych.
Ograniczenia
- Generowanie obrazów nie jest obsługiwane bezpośrednio.
- Generowanie dźwięku jest niedostępne.
- Computer Use pozostaje w wersji zapoznawczej.
- Niektóre starsze parametry generowania (
temperature,top_p,top_k) zostały usunięte z nowego interfejsu API. - Najlepszą wydajność uzyskuje się dzięki najnowszemu Gemini Interactions API.
Jak uzyskać dostęp do Gemini 3.6 Flash API
Krok 1: Uzyskaj dostęp do API
Zaloguj się do cometAPI. Jeśli nie jesteś jeszcze naszym użytkownikiem, najpierw się zarejestruj. Zaloguj się do swojego CometAPI console. Uzyskaj poświadczenie dostępu — klucz API interfejsu. Kliknij „Add Token” przy tokenie API w centrum osobistym, pobierz klucz tokena: sk-xxxxx i zatwierdź.
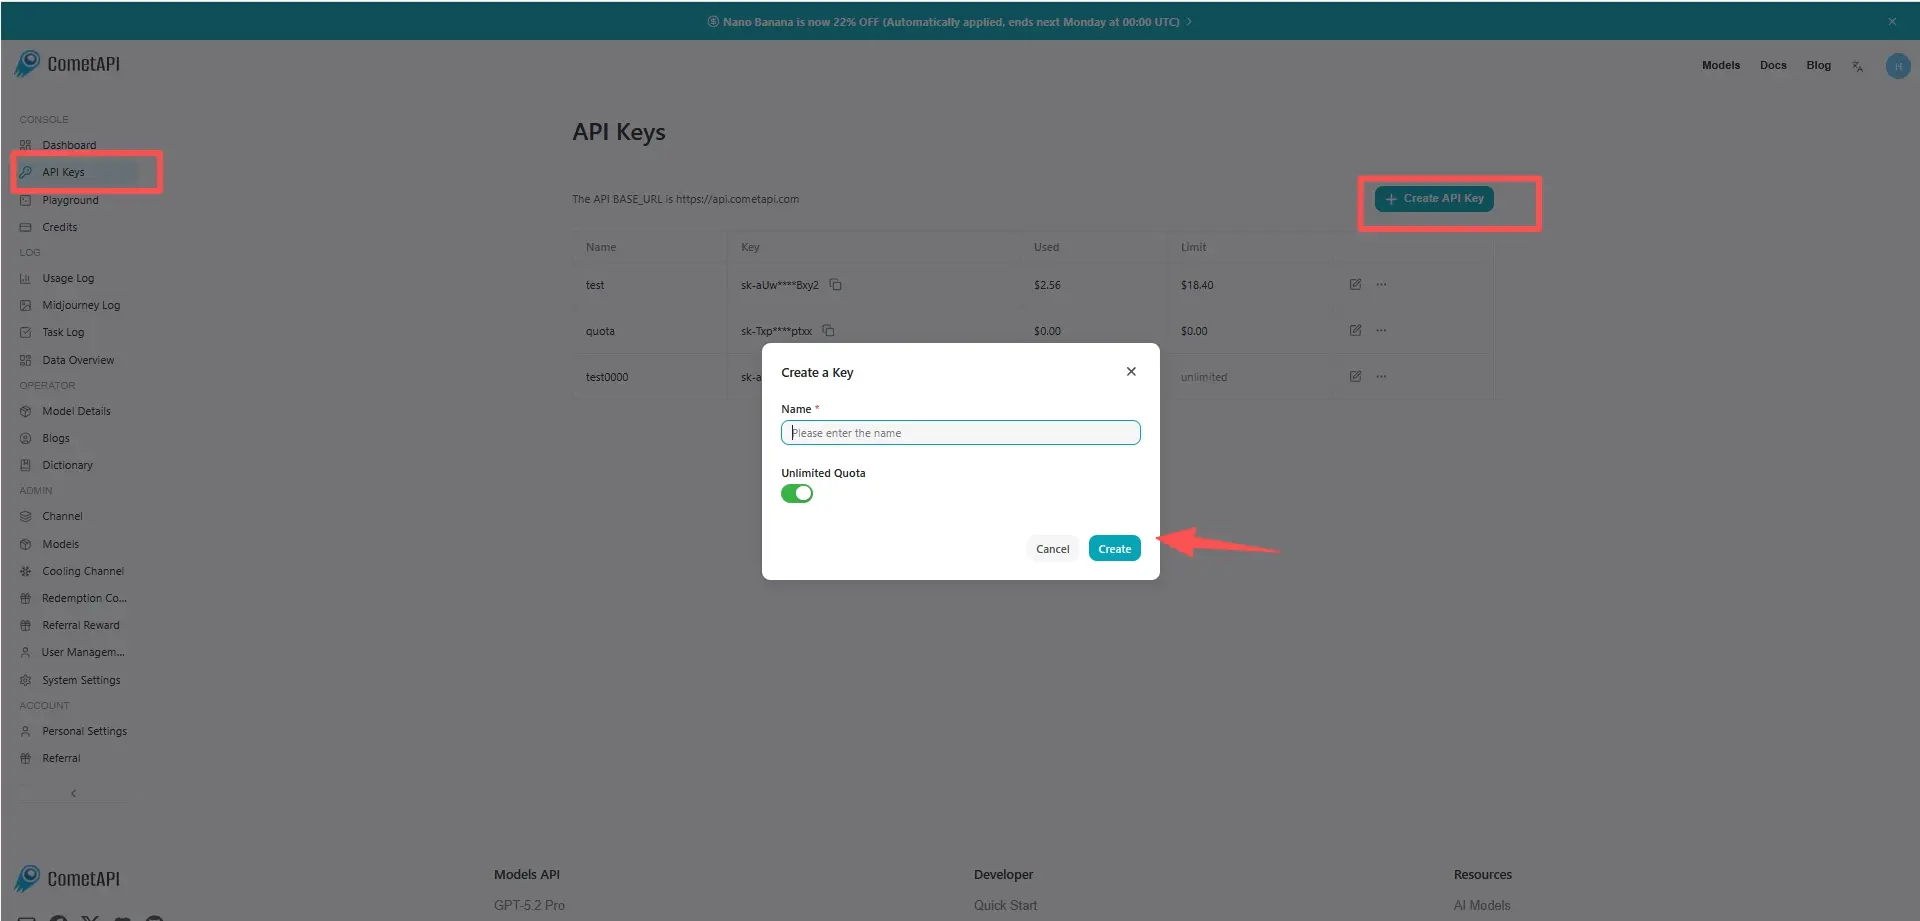
Krok 2: Wyślij żądania do Gemini 3.6 Flash API
Wybierz endpoint „ gemini-3.6-flash" "gemini-3.6-flash-thinking” do wysłania żądania API i ustaw ciało żądania. Metodę i ciało żądania można uzyskać z dokumentacji API na naszej stronie. Nasza strona oferuje także test w Apifox dla Twojej wygody. Replace <YOUR_API_KEY> with your actual CometAPI key from your account. base url is Gemini Generating Content
Wstaw swoje pytanie lub prośbę do pola content — na to model odpowie . Przetwórz odpowiedź API, aby uzyskać wygenerowaną odpowiedź.
Krok 3: Przetwarzaj odpowiedzi
API zwraca ustrukturyzowane odpowiedzi-kandydaty, w tym wygenerowany tekst, odwołania do źródeł, metadane bezpieczeństwa oraz opcjonalne wyniki narzędzi.